前言
这门课的资料非常详尽,所以基本上我只是做了翻译和摘录,鲜有改进。
课程介绍
这门课是基于计组,计算机系统和电路组成(我上过这课吗)的综合课程,旨在设计集成电路。 参考书籍有:
- Harris D., Harris S. Digital Design and Computer Architecture. – 2nd edition. –
Morgan Kaufmann, 2012. – P. 712. - Rabaey J., Chandrakasan A., Nikolic B. Digital Integrated Circuits. – Pearson,
- – P. 800.
- Readler B. Verilog by Example: A Concise Introduction for FPGA Design. - Full
Arc Press; First Edition, 2011. – P. 124. - Weste N.H.E., Harris D.M. CMOS VLSI design: A circuits and systems
perspective. – 4th edition. – Pearson, 2010. – P. 880 - Baker R. J. CMOS: Circuit Design, Layout, and Simulation. – 3rd edition. – Wiley-
IEEE Press, 2019. – P. 1280Soc
system on chip 通常情况下,硅芯片包含多个处理器核心、图形处理单元、各种编解码器(如视频编解码器)、输入/输出设备等。由此可见,集成电路是一种极其复杂的器件。在我们的课程中,我们将学习如何开发这些组件。
数字信号
模拟信号:连续信号,有无穷个值。 数字信号:离散信号,有限个值,(通常来说)使用1和0两种逻辑值。比如以5v为逻辑1,0v为逻辑0 这个电压是随意的,例如5V VCC,3.3V VCC,Vout表示输出高电平,Vin表示输入高电平。对于一些零件来说,也可能会有高电压输入低电压输出的情况,这是为了抑制噪声的考虑或各种环境因素的损耗影响。
| 符号 | 含义 | | — | — | | VCC | 电源电压(供电),比如 5V 系列就是 5.0V,3.3V 系列就是 3.3V | | VOH | 输出高电平:芯片输出”1”时,最差情况下引脚上至少有这么高的电压 | | VOL | 输出低电平:芯片输出”0”时,最差情况下引脚上至多这么高 | | VIH | 输入判高门限:输入电压高于它,接收方才保证当成”1” | | VIL | 输入判低门限:输入电压低于它,才保证当成”0” | | VT | 翻转阈值(threshold),实际比较器翻转点,介于 VIL 和 VIH 之间 | 也正是环境的影响,数字信号的上升沿和下降沿都不一定是垂直的,由于电路中的电容和电感,基本上不可能出现理想的数字信号形式。 通常来说,上升沿被称为正沿,下降沿称为负沿,后续我们将继续使用这两个术语。组合逻辑
组合逻辑:输出由输入信号的组合决定。
例如,在算术逻辑单元(ALU)中,如果我们将 2 放入输入 A,将 3 放入输入 B,ALU 进行加法运算,我们将“立即”在输出 Y 得到 5。得到结果的时间仅与信号通过电路所需的时间有关。如果我们将输入值改为 1 和 5,我们将在输出中得到 6。这就是组合逻辑,我们改变输入,立刻得到结果。
另外一个概念是时序逻辑。
输出由输入信号和先前状态的组合决定。这意味着它是一种具有记忆功能的电路。例如,寄存器、计数器、移位寄存器都基于时序逻辑。这种逻辑可以存储先前的状态,常用于寄存器。时钟信号
时钟信号用于时序逻辑的同步,由于使用多个时钟信号会出现亚稳态等问题,因此课程中尽量只用一个时钟信号。
例如,假设我们有两个 D 触发器(每个触发器存储 1 位数据),需要将一个信号从一个 D 触发器传输到另一个 D 触发器。如果这两个触发器使用不同的时钟信号,则无法进行传输。两个触发器必须通过一个时钟信号的上升沿或下降沿进行同步。在这种情况下,我们可以使用时钟信号上的某个事件,将一位信息存储在第一个或第二个 D 触发器中
所有时钟信号都存在不确定性。这意味着时钟信号的周期可能会有很小的偏差,因此 T1(第一个周期)不会等于 T2(第二个周期)。不确定性的大小与时钟质量相关:不确定性越小,时钟质量越好。如何表述?
下一个问题是我们如何表达我们的电路方案。 我们可以使用图片,也可以使用文本(或代码)。使用图片,我们可以直观地看到方案的功能实现方式,而文本表示则提供了功能方面的信息。图片适用于小型方案,而文本表示适用于大型方案。目前有两种流行的硬件描述语言(HDL):VHDL 和 Verilog HDL。
HDL 帮助我们用简单的方程来描述复杂的方案。它可以描述硬件电路的结构和行为。抽象层次
和语言一样,硬件描述语言也有它自己的抽象层次。
和玩图灵完备一样,原理图级别我们要用晶体管来创建最基本的电路图。之后,我们可以获得各种门电路,它是若干布尔逻辑门的组合,使得这种元件可以实现布尔运算,例如与门或门非门(这个之后有空会讨论)。 然后,我们进一步组合,获得了由门电路组成的基本功能模块,比如加法器,乘法器和多路复用器,解复用器寄存器计数器….. 最后,我们得到了 模块/IP核 ,包括CPU,GPU,IO控制器等等。这些模块由基本功能模块组成。
我们将使用基本功能模块来创建电路图。这就是为什么我们的课程叫做functional electronic circuits。我们要做的就是去制作IP核,IP指的是知识产权。
在电路图中混用不同层次的表示方法是不可取的。如果你的电路图基于晶体管,那么整个电路图都应该用晶体管来表示。例如,在逻辑门电路图中就不应该出现晶体管或功能模块。
基本功能块级别也称为 RTL = 寄存器传输级别。开发
开发工具
开发过程中的主要目标是创建一些特殊工具,以提高将不同模块从一种表示形式转换为另一种表示形式的自动化水平。
理想情况下,所有开发人员都希望系统模型、可执行模型、功能电路和集成电路之间的转换能够完全由某些 CAD 工具实现,而无需开发人员干预。但目前,这是不可能的。为了实现不同形式的转换,需要使用不同的语言来正式描述系统。
为了实现不同形式的转换,我们可以使用不同的语言来正式描述系统级别,例如 SysML、xtUML 和 UML 等。创建可执行模型时,我们可以使用 Matlab、Maple、C/C++、Python、LISP、Haskell 和 Java 等。开发功能性电子电路时,我们可以使用 Bluespec、SystemVerilog/Verilog、VHDL、SystemC 和块设计语言等。
现在我们有一些高级综合(HLS)(屎山)工具可以将可执行模型转换为功能电路。也有一些工具可以将功能电子电路转换为集成电路并将其实现为芯片。但是,我们还没有工具可以将系统模型转换为可执行模型,因为从“你想要什么”到“它应该如何工作”的转换目前还无法自动化。这个问题尚未解决。
目前的HLS通常有:
Vivado HLS (Xilinx赛灵思)
• Catapult HLS (Siemens西门子)
• Stratus HLS (Cadence)
• HLS Compiler (Intel牢英)
• Synphony HLS (Synopsys)
晶体管电路
现代方案中晶体管一般使用CMOS技术(互补金属氧化物半导体)。这种设计基于两种晶体管,n MOS和p MOS,虽然这是两种晶体管,但是我们的学习不需要了解其基本物理特性和原理,只需要理解为一种抽象的元件就行——互补的意思就是有两种不同工作方式的晶体管,MOS意味着我们使用半导体衬底(金属M-氧化物O-S半导体),以及半导体组成的n沟道和p沟道。它具有称之为源极,栅极,漏极的金属电极,栅极之间以二氧化硅作为材料。 栅极是控制源极和漏极之间电流流动的关键电极。
- 对于n-MOS:
你可以看到一个 n 沟道 MOS 晶体管。它可以导通,也可以关断。栅极触点就像一把钥匙:它控制晶体管的导通或关断状态。当栅极信号为逻辑 0 时,钥匙断开(无电流);当栅极信号为逻辑 1 时,钥匙关断(有电流)。这就是晶体管的“钥匙模式(key mode)”。
如果我们把栅极设置为逻辑0,然后源极接地,那电流将无法流动,钥匙会打开(开路),但如果栅极和源极的电压大于0,则漏极和源极之间会有电流流动。
- 接下来讨论p-MOS: 它的工作方式与 n-MOS 晶体管不同。源极需要连接到电压源。如果我们将栅极电压设置为逻辑 1,晶体管将导通(没有电流通过)。但如果我们将栅极电压设置为逻辑 0,则源极到漏极之间会有电流通过,晶体管将导通
门电路
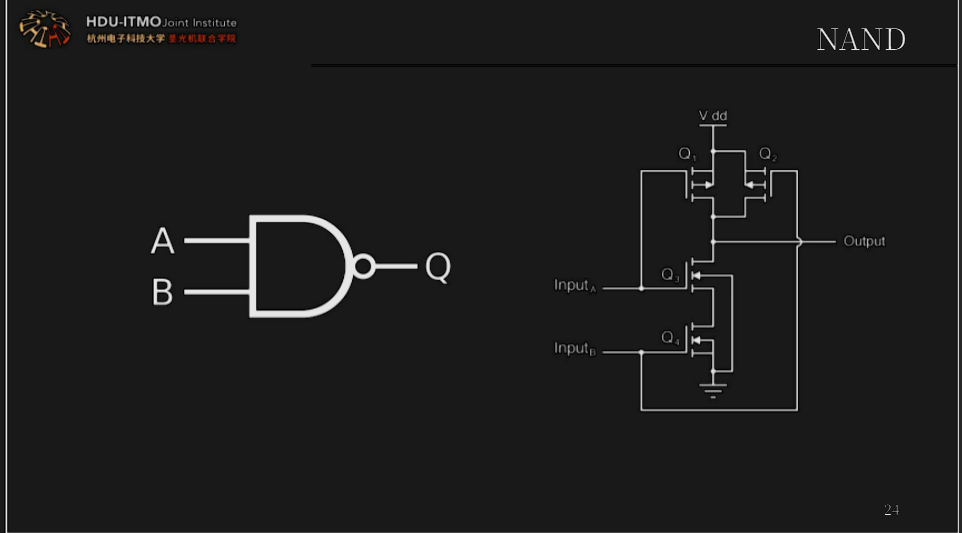
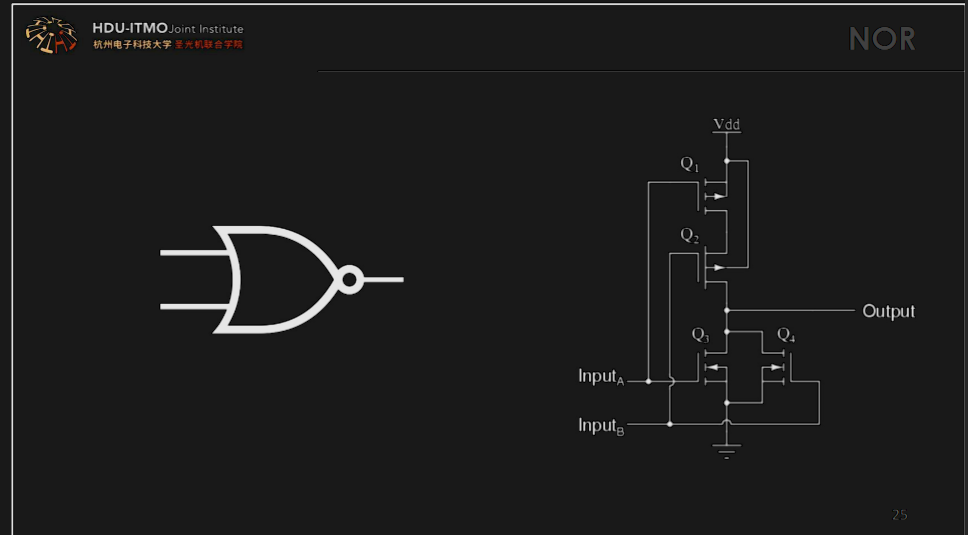
回顾一下一些逻辑门的工作原理: 我们将讨论两种类型的逻辑门:与非门(NAND)和或非门(NOR)。它们是 CMOS 逻辑的基础。有些工厂只使用与非门,而有些工厂只使用或非门。这取决于工厂能够生产哪种类型的逻辑门。仅使用与非门或仅使用或非门就可以创建任意复杂度的数字电路。
- 真值表
与非门NAND:
或非门NOR:
NAND加法器: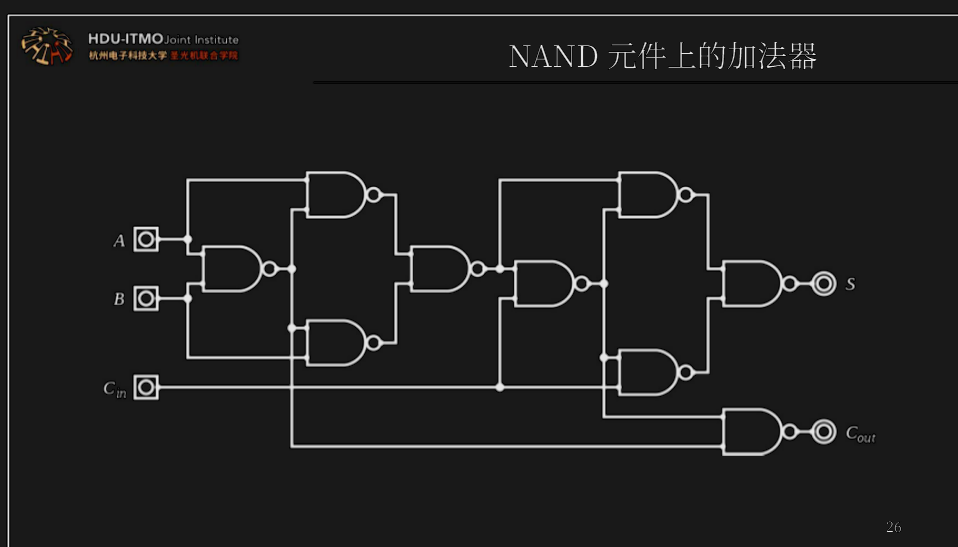 后续的时序寄存器,SR/RS触发器之类,没有细讲。我也更建议玩图灵完备去理解。我们只需要知道,S为1,R为0,则在时钟边沿(正负取决于SR/RS)可以将1储存到Q,反正S0,R1则储存0.
再就是 JK 触发器。其中 J 代表跳转,K 代表终止。如果我们把 K 输入端设为 1,把 J 输入端设为 0,电路就会复位,相当于存储逻辑零。反之,J为1,K为0,则逻辑1,都为1,则反转其值。
利用SR触发器和JK触发器可以构建D触发器,D触发器可以由SR或者JK触发器构建,D触发器用于储存1位信息,它是一个1位储存单元。如果我们需要储存更多位数的信息,可以把多个D触发器串联起来,得到一个1byte的数据寄存器。基本功能模块
多路复用器、解复用器
多路复用器是一种数据选择器。多路复用器是一种组合逻辑网络,它从多个可能的输入信号中选择一个,并将该信号导向单个输出端。特定输入的选择由一组选择变量控制。一个具有 n 个选择变量的多路复用器通常可以从 2^n 个输入信号中选择一个。
在电路图中,它可以表示为一个具有 2 位地址、4 位输入和 1 位输出的块。
解复用器(或数据分配器)与复用器正好相反。它接收单个数据输入,并将其路由到多个可能的输出之一。它是具有 2 位地址、1 个输入和 4 位输出的模块。
译码器
下一个基本功能模块是译码器。您可以在幻灯片中看到,它有一个输入代码和一个输出代码。这里我们看到的是一个位置译码器。这意味着我们以位置作为输入,并在相应的输出中得到逻辑 1。例如,输入 010 会将 Q2 设置为 1,而输入 110 会将 Q6 设置为 1。译码器可以有很多种,这里展示的只是其中一种。
编码是将一组输入形成编码表示的过程,它是译码操作的逆过程。编码器是一种组合网络,它生成一个 n 位二进制代码,该代码唯一标识 m 个激活输入中的一个(0 ≤ m ≤ 2− 1)。 编码器的功能与解码器相反:它将位置编码转换为二进制编码。幻灯片中展示的是一个位置编码器。同样的,编码器还有其他类型。
算数模块
下一类模块是算术模块。它们可以用逻辑门构建。在电路图中,我们将算术模块称为 ALU 模块。ALU 的符号表示输入 A 和 B、一些操作码输入、输出以及对输出执行的操作符号。它可以执行加法、乘法等运算。
加法器,半加器
寄存器
接着的功能模块是一个 4 位寄存器。可以看到,它是一个时序逻辑模块,可以存储 4 位信息,是一个 4 位存储单元。
我们可以创建一个移位寄存器,它在每个时钟信号(本例中为上升沿)时将值从一位移到另一位。它用于 I/O 控制器中的顺序数据传输。
计数器
最后一个基本模块是计数器。你可以从图中看到它的工作原理:每个时钟周期,计数器改变 Q0 的输出值;每两个时钟周期改变 Q1 的输出值;每四个时钟周期改变 Q2 的输出值。因此,每个输出都会产生一个频率比前一个输出低两倍的方波信号。
对于每个时钟周期,我们将在 Q 输出上得到相应的代码:000、001、010、011、100、101、110、111、000 等等。
时序部分
第二讲主要涉及数字设计中架构和微架构的定义,然后讨论数字方案中的同步和时钟问题,接着探讨通信基础设施及其在集成电路和数字设计中的实现方式。
架构是一套描述计算机系统功能,组织和实现的规则和方法。微架构是实现架构的方式。我们的目的就是为了一些简单方案,CPU和加速器等开发微架构。
MIPS处理器
微架构主要可以分为两部分:数据流和控制流
数据流
描述数据如何从一个模块到另外一个模块,影响计算性能。
控制流
描述各个功能单元中操作的执行方式,控制单元负责实现与数据流处理相关的算法。
如果我们再来看看简单的单周期 MIPS 处理器的微架构图,就会发现:控制流相关的模块和连接被标为蓝色,而数据流相关的模块和连接则被标为黑色。在开发项目时,必须明确区分这些控制流和数据流部分。如果将控制流和数据流相关的模块混在一起,虽然该架构在当前可能还能使用,但将来很难进行扩展和进一步开发。这样的架构也难以理解。为了使设计更易于理解,最好将微架构分为两个主要部分:控制流和数据流。因此,在设计时,应分别绘制这两个部分。控制流通常由控制单元构成(例如,可以由微程序控制单元或有限状态机来实现),此外还包括一些控制相关的组件
接下来你需要熟悉的新术语是实现类型。微架构可以通过多种方式实现:可以实现单周期实现、多周期实现和流水线实现。
One-Cycle implementation
一周期实现——处理任务可在一个周期内完成。所有计算都是通过将数据传递到多个模块的组合中来完成的。 例如取y=x^5,它应该会进行乘以 x 五次的操作。对于一个周期实现,我们应逐个使用五个乘法器,然后将结果保存到寄存器中。从图片中你可以看到,每个时钟周期都会保存到寄存器。所以我们每个时钟
单周期实现是处理单元或者任何功能模块中最简单的组成部分。Onecycle 实现每次操作都需要独立的计算资源,且运行频率相对较低。
您可以看到,这里我们只使用了一个乘法器,但重复使用了五次。如果乘法器的传播延迟相同,则最小时钟周期应大于 1 ns。但计算过程需要 4 个时钟周期。此方案适用于高频时钟。左侧的示意图展示了一些控制逻辑和一个计数器。
Multicycle implementation(流水线实现)
多周期实现,能够在多个周期内使用相同的计算资源来完成。例如,要进行多个加法,你先做一个加法器块,并在不同时刻多次使用。 多周期实现允许通过在请求处理的不同阶段重复利用计算资源来节省计算资源,因此,它需要缓冲区,
对于同上的计算,我们需要四个时钟周期来完成。但是对于第二个及以后的数字,我们只需要一个时钟周期来计算 x。
时间参数
每个在寄存器(D 触发器)上实现的静态存储器都有建立时间和保持时间这两个参数。
建立时间 (tsu) 指的是同步输入 (D) 的数据在时钟有效边沿到来之前必须保持稳定的时间。图中显示了 tsu 周期和时钟上升沿。在整个 tsu 时间内,D 输出端的逻辑信号值应该保持稳定。
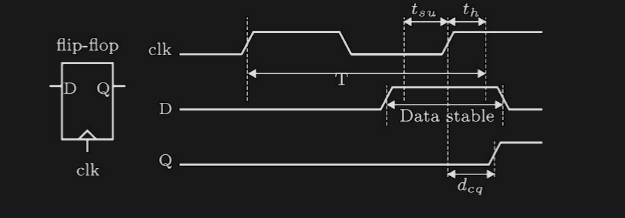 我们应该在上升沿之后保持输出信号值一段时间。这段时间称为保持时间。
保持时间 (th) – 时钟有效边沿过后,同步输入 (D) 处的数据必须保持稳定的时间。在这种情况下,您将获得稳定的数据输出(Q)。
我们应该在组合电路之间插入一些寄存器,并使用相同的时钟信号进行同步。例如(见图),您可以将值存储在 DFF2 中,然后将该值提供给组合电路,并在下一个时钟信号到来时将新值(计算结果)存储在 DFF3 中。在这种情况下,运行此电路所需的最小时钟周期为:
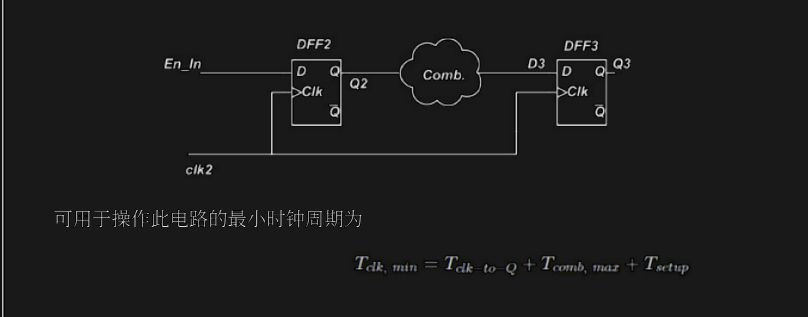
这里,第一个 Tc 是时钟到 Q 信号的传播延迟,第二个 Tm 是组合电路的传播延迟,最后一个 Tm 是建立时间。这个值给出了该方案的最大频率。
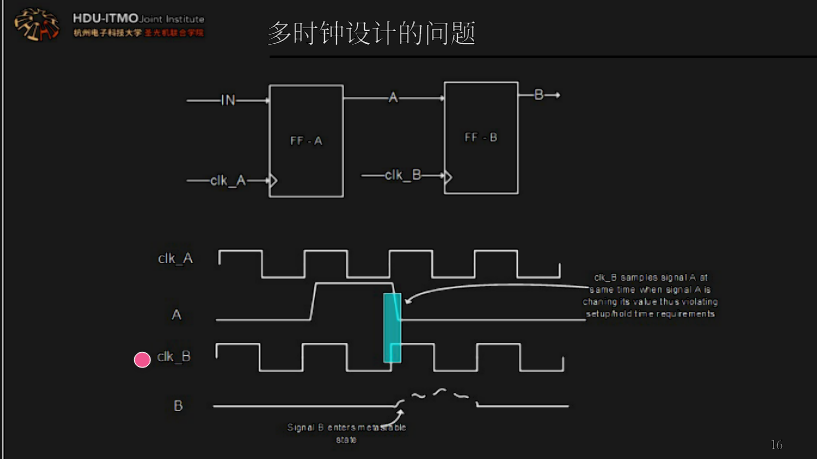
如果使用多个时钟同步各个器件,电路中可能会出现亚稳态信号。如图所示,时钟 Clk_B 违反了信号 A 的保持时间要求,导致输出 B 出现错误信号。
时钟域交叉技术(CDC)
有几种技术可以避免这种情况,但它们相当复杂,所以最好使用一个时钟信号来同步方案中的所有设备。
避免电路中出现亚稳态信号的第一种方法是使用两个触发器而不是一个。这种方法称为双触发器同步器。其中,第一个触发器处于亚稳态,从而降低了第二个触发器输出端出现亚稳态的可能性。
另一种技术采用所谓的“握手”方法。它使用两个信号:请求信号和确认信号。如果源控制和目标控制使用不同的时钟,则需要使用请求信号和确认信号,并通过两个触发器同步器来避免方案中的亚稳态信号。该方案的工作原理如下:如果源设备想要发送数据,它会生成请求信号。目标设备生成确认信号作为响应,然后源设备可以将数据发送到目标设备。在我们的实验中,为了避免此类问题,我们将只使用一个时钟信号。
我们在此总结了几条钟表设计规则:
- 当信号从一个时钟域传输到另一个时钟域时,需要消除两个时钟域之间的组合逻辑路径。这需要插入寄存器。
-
构成同步电路的触发器必须彼此靠近放置,以尽可能减小它们之间的时钟偏差。你需要将触发器紧密地排列在一起。
- 切勿在多个地方同步同一信号。
- 数据总线上不要使用双触发器同步方案,而应使用握手同步技术。
- 花时间设计CDC是值得的。
模块通信基础
现有的拓扑结构有多种:星型、环型/链型、公共总线型。这些拓扑结构适用于不同的应用。例如,星型拓扑可用于设备网络,例如计算机中的 PCI Express 设备。环型拓扑可用于调试接口,例如 JTAG 接口,以减少信号数量。公共总线型拓扑用于片上系统设计和其他类型的设计中,将所有功能核心相互连接。如图所示,该系统由总线矩阵组成,该总线矩阵用于连接其他模块。
虽然总线标准各不相同,但它们彼此之间非常相似。例如,ARM 处理器使用 AMBA AXI 总线标准。一些 MIPS 处理器使用 OCP 总线,而一些开放式设计的芯片则使用 Wishbone 总线。我们应该明白,如果使用某种通信标准,就可以轻松扩展系统(以后可以根据需要添加新模块),因为它遵循相同的规则。例如,每种总线标准都有明确的数据传输规则。例如,需要先设置地址,然后改变 HWRITE 信号,最后才能读取数据。写入数据时,也需要先设置地址,然后设置 HWRITE 信号,最后写入数据。这种规范(如幻灯片所示)适用于所有总线。
但它们彼此之间的标准都非常相似。不过,在您的设计中,您可以创建自己的总线并指定通信规则。
总线实现
总线实现方式有两种:共享总线和交叉开关。共享总线
共享总线:
硬件成本最低,结构最简单
系统扩展会降低性能,因为每个模块都可以与其他模块一起工作,而其他模块则在等待公共总线空闲。
修改硬件系统配置很容易,因为我们可以毫无问题地连接新的模块。
我们不能同时从所有内存模块传输数据,因为公共总线只能使用一个内存块。
交叉总线:
第二种类型是交叉开关。交叉开关是一个矩阵,它允许 CPU 与内存模块通信。当一个 CPU 正在使用一个内存模块时,另一个 CPU 可以同时使用另一个内存模块。这样就可以并行执行操作。
仅适用于多处理器,因为只需要一个基本的开关矩阵,因此具有成本效益。
系统扩展可以提升性能
传输速率高,但更复杂
系统扩展受限,仅可通过开关矩阵的大小进行扩展。
我们可以同时从所有内存模块进行数据传输。
芯片网络
另一种现代通信组织形式是芯片网络。
片上网络(NoC)是一种新兴的范式,用于在单个硅芯片上实现大型 VLSI 系统内的通信。
片上网络 (NoC) 链路可以降低线缆设计的复杂性,从而实现可预测的速度、功率、噪声和可靠性。
由于片上网络中的所有链路都可以同时处理不同的数据包,因此可以实现高度并行性。
片上网络(NoC)的核心思想是将网络的基本原理应用到单个芯片上。图中可以看到多个核心。
片上网络(NoC)的核心思想是将网络的基本原理应用到单个芯片上。图中可以看到多个核心。
这里,IP 核是一个功能单元,可以执行以下操作:
HDL语言
这里我旷了节课,根据印象简单讲讲:
软核和硬核处理器
任何数字电路都可以通过两种方式实现:集成电路ASIC,或现场可编程门阵列FPGA。
ip核:是半导体产业中的一种产品,有可以在许多设计中复用的形式。
软处理器核心:处理器的实现可以在不同平台间迁移。
硬处理器核心:与部分工艺流程,门电路基础等相关的不可改变的因素相关。
实验课上,我们通过编写 Verilog HDL 代码来实现软核,这些代码可以转换成集成电路或 FPGA 代码。而且,我们可以将它从一个平台移植到另一个平台,这意味着它是软核。
常见是软处理器核心有:
SRC1
Rocket
OpenRISC(以上的其实都是RISC-V)
ZPU
Microblaze
NIOS
FPGA
FPGA是由
CLB-可配置逻辑块
CB-连接盒
SB-开关盒
组成的。每个CLB模块都可以与其他的LCB模块协同合作,因为它们通过CB和SB彼此相连。
容易想象得出,CLB
CLB是由查找表LUT和触发器FF组成的。CLB可用于实现组合逻辑电路和时序逻辑电路(前面提到过的)。对于组合逻辑电路可用LUT,后者可用CLB。它通过组合两种资源实现各种各样的逻辑。
LUT(Look-Up Table,查找表)的本质是一块极小的 1 位存储器 + 地址译码器。
原理:任何布尔函数都可以用真值表完整描述。以图中 4 输入 LUT 为例——4 个输入有 2⁴ = 16 种组合,每种组合对应一个确定的输出值。那干脆把这 16 个输出值预先存进 16 个 SRAM 单元里,把 A₁~A₄ 四根输入线当成 4 位地址送进去,地址译码后选中对应的单元,“读”出来的值就是函数输出。
比如要实现 F = A₁·A₂ + A₃·A₄,工具软件会把 16 种输入组合下的正确结果算出来,在配置时写进这 16 个存储位。之后不管来什么输入,查表就是答案——不搭任何门电路,用存储代替运算。图中 LUT 下面那个小方框,就是保存这 16 位配置数据的配置单元。
这也是 COA 里讲过的思想:任何组合函数都能用 ROM 实现,LUT 就是把这个思路做到极致、做成可重写的小 ROM。
LUT 只能做组合逻辑:输出只取决于当前输入,断电即忘,没有状态。但计数器、状态机、寄存器这类时序逻辑必须记住“上一拍是什么”。
FF(Flip-Flop,触发器)就是边缘触发的 D 触发器:在 CLK 时钟上升沿,把 D 端的值锁存进 Q,其余时间 Q 保持不变。图里每个 LUT 配一个 FF,还带 R(复位)、S(置位)控制线,用来异步清零或置一。
简单来说,就是你可以通过模拟真值表的行为来模拟任何一种组合逻辑电路。
现在有个例子,用CLB实现异或门。
图中的是一个四输入查找表 (LUT) 结构,它可以实现任何组合电路、任何逻辑门以及任何基于逻辑门的电路方案。右侧是异或门的真值表,它表明当异或门的输入不同时,其输出为真。
图中四个空白方格代表配置存储器。我们需要在其中放置一些值来实现异或(XOR)真值表。例如,如果输入 i1 和 i2 均为 0,则输出 y 应为 0。如何实现呢?三个输入分别为 i1 和 i2 的模块是多路复用器,它们可以根据控制信号 i1 和 i2 改变输出。如果我们将 i1 和 i2 都设置为 0,则输出 y 应为 0。为此,我们需要在最上面的方格中写入 0。在第二个序列中,i1 为 0,i2 为 1,输出 y 应为 1。因此,第三个方格的路径将被激活。为此,我们需要在第三个方格存储单元中写入 1。依此类推。最终,配置存储器中的数据将为 0 1 1 0。因此,配置存储器中的这些值将使该方案能够像异或门一样工作。
现代的FPGA还包含高速接口,BRAM,DSP块和MCU,用于各种计算和外部连接。
当然,FPGA本质上是集成电路的组合,它能做的集成电路也能做:
这些功能实现方案各有特点:就频率而言(例如时钟信号的频率),FPGA 的最大可用频率始终低于集成电路的频率。FPGA 的最大频率约为 200 MHz,而集成电路的最大时钟频率约为 3 GHz。
费林处理器分类法
根据指令数据的不同,处理器又有以下分类:
SISD(单指令单数据流,单核处理器)。例如,我们有一个处理器、一个数据存储器和一个指令存储器。我们可以使用一个处理核心来执行一些数据相加操作。
单指令多数据流(SIMD)(GPU、Intel SIMD 扩展)。例如,我们可以在这里将多个值相乘,为此可以使用多个处理器单元。这些处理器单元可以是 GPU 或向量协处理器。这种结构可用于数学运算,例如向量乘法。
MISD 多指令单数据(脉动阵列等)意味着我们有不同的结构对应一种数据。
这种架构使用单条指令处理同一组数据,例如,在某些数字信号处理中,我们需要对同一组数据执行多个操作。数据从一个处理器单元定向到另一个处理器单元。这种架构常用于脉动阵列。
MIMD(多指令多数据流,并行计算机)。所有处理器单元都是独立的,可以处理各自的数据并执行各自的指令。这种处理器用于并行计算机。
硬件加速器
我们常听到FPGA和ASIC加速了各种东西,这就是所谓的硬件加速器。
们可以创建并行硬件加速器,使其能够在较低的时钟频率下工作;而使用较低的时钟频率就相当于降低了功耗。
硬件加速器可以通过多种方式集成到电路中:
第一种方法是开发自定义指令。
处理器架构可以通过硬件加速器实现的自定义指令进行扩展。例如,如果某个处理器只能实现加法、减法、移位运算和逻辑运算,我们可以添加一些自定义运算,例如除法、乘法、幂运算或对数计算等等。我们可以设计一些硬件加速器来实现这些自定义指令,并将它们添加到计算机的指令集中。
所有自定义指令都有类似的结构:它们最多包含两个数据输入和一个数据输出,以及可选的时钟、复位、模式、地址和状态信号,以便进行更复杂的多周期操作,从而了解何时可以获得结果。
自定义指令是一种阻塞操作,它会阻止处理器执行其他指令,直到自定义指令完成。虽然这会降低性能,但自定义指令的执行时间通常很短,因此对整体性能的影响不会非常显著。这种做法通常又叫做协处理器。
另一种硬件加速器集成方式是使用独立的模块。在示意图中可以看到,CPU 可以通过系统总线与硬件加速器 (HW1) 通信。
这种情况下它和普通的外设类似,都在内存里映射。
每个硬件加速器的寄存器都映射到 CPU 地址空间,该地址空间显示在幻灯片的右侧。可以看到,该地址空间的一部分与存储数据和指令的主内存相关联,下一部分与硬件加速器 1 相关联,再下一部分与硬件加速器 2 相关联。CPU 需要使用内存操作来获取和存储硬件加速器中的数据。没有特定的指令来执行计算。CPU 需要知道硬件加速器寄存器在内存中的位置,才能寻址、获取和存储数据。GPU 就是这样连接到 CPU 的。
最常见的一种协处理器:向量协处理器。
向量协处理器拥有多个寄存器,这些寄存器可以划分成多个槽位。每个槽位可以表示特定格式的数字,例如浮点数、双精度浮点数、整数、双字节格式和单字节格式。我们还可以使用白名单寄存器。这是英特尔处理器中 SSE/AVX 数据类型的示例。我们可以利用这些格式,在一个时钟周期内通过一条指令对 32 个 8 位值进行运算。这可以显著提高处理矩阵或数组时的性能。
我们可以用向量进行两种基本类型的操作:垂直向量指令和水平向量指令。
虽然具体的细节最好是参考手册
https://www.ics.uci.edu/~swjun/courses/2019S-CS295/slides/,但是我这里可以粗略地讲一讲它们实际长啥样;
- 垂直向量指令:
你可以把一系列的矩阵操作,每个矩阵元素都提取出来占用一个专门的寄存器位置,然后相对的操作数元素就放在同一列的位置,每次执行指令就是对一整行的数据加上或者乘以下一行的数据。
它用于加法、减法、乘法、求最大值和最小值、进行移位、计算平方根以及融合乘法和加法运算。 - 水平向量指令:
第二种向量指令是水平指令。它允许我们计算一个寄存器中两个相邻值的结果。例如,将两个双精度浮点数相加,并将结果存储到另一个寄存器中。这样,我们就可以在一个寄存器中操作特定字段。这种指令常用于数据数组操作。
它更倾向于在寄存器中水平排列元素,然后使得相邻的几个元素相加/相乘。
当我们需要执行乘加运算时,可以使用 for 循环。如果使用 SISD 处理器,则需要执行大量运算(8 次加法、8 次乘法、8 次比较和 8 次加法加法,总共 32 次运算),并且一个循环需要 8 次迭代。但如果使用向量协处理器,只需一条指令_mm256_fmadd_ps即可完成相同的计算,并在一个循环内获得结果。因此,与 SISD 处理器相比,性能将提升 32 倍。GPU
耳熟能详的GPU实际上是一种图形硬件加速器。 多核 CPU 包含多个核心,但每个核心都是一个复杂的设备,根据特定的程序运行。GPU 则是一种 SIMD 设备。GPU 由数百个核心组成,但每个核心的结构比 CPU 核心的结构简单得多。GPU 核心可以执行诸如加法或乘法等简单运算。每个现代 GPU 都包含多个流式多处理器(SM)。幻灯片中展示了 GPU 的结构。每个流式多处理器中包含多个核心。它不仅可以用于图形处理,还可以用于处理通用数据,例如科学计算、处理大型数组或大数据等等。
典型的编程流程如图所示。在一个处理器(红色)中,我们使用顺序执行;而在 GPU 中,并行执行是通过单指令实现的。首先,我们需要将数据从主内存复制到 GPU 内存。然后,我们需要将配置信息发送给 GPU,之后开始处理:数据将由多个核心并行处理,最后,我们需要将结果复制到主内存。
当使用系统总线连接硬件加速器时,数据在主内存和内存之间的复制会成为瓶颈。为了解决这个问题,我们可以使用共享内存,即在芯片上集成一个系统,其中包含 GPU,并且内存和 GPU 都位于同一设备中。在这种情况下,主多核 CPU 无需在内存之间移动数据,GPU 可以直接从主内存中获取数据。
npu
现在我们将简要讨论可作为基于神经网络的硬件加速器的神经网络处理器。
第一种架构类型是流水线架构。它具有全局内存,以及分别用于存储输入数据和输出数据的局部内存块(MemRD 和 MemWR)。输入数据从全局内存传输到输入局部内存,然后在网络的不同层执行一些计算(例如卷积、池化等)。计算结果存储在输出局部内存中,然后被复制回全局内存。
每个块中的计算都在多个计算单元中执行,并使用流水线式乘加器树来执行所有计算。
这里再举一个例子:谷歌张量处理器单元TPU(Tensor Processor Unit)。它的结构与脉动数组的结构类似。它也使用脉动数组来执行矩阵乘法并生成所有数据并行计算。
CPU、GPU 和 TPU 的区别在于:CPU 需要逐个执行每个神经元的计算,速度非常慢;GPU 可以使用数组或向量并行计算神经元,但需要将中间计算结果存储在内存中,导致功耗巨大;而 TPU 可以使用矩阵运算,无需访问内存。因此,GPU 更适合训练神经网络,而 TPU 更适合推理(无需访问内存即可计算输出)。
HDL
Datapath(数据通路)就是数字系统里“数据实际流过、被加工”的那部分硬件:寄存器、ALU、加法器、移位器、多路选择器(mux)、连接它们的总线。它只负责搬运和运算,不负责决定“什么时候、按什么顺序做”。
与之相对的是 controller(控制器),通常是一个有限状态机(FSM),根据当前状态和状态标志产生控制信号去指挥 datapath:mux 选哪条分支、ALU 做哪种运算、哪个寄存器使能写入。
HDL 教材反复强调这个划分,因为它是 RTL 设计的标准方法论:先把要实现的功能映射成一个由寄存器和运算单元组成的 datapath 结构,再单独写一个 FSM 驱动它,顶层把两者 instantiate 到一起。这种结构有个名字叫 FSMD(FSM with Datapath)。
Systolic array(脉动阵列)是由大量相同的小处理单元(PE)排成规则网格、数据像脉搏一样周期性“泵”过阵列的并行计算结构。 这个词是 H.T. Kung 和 Leiserson 在 1978 年造的,取自医学术语“心脏收缩期”(systole):外部存储器扮演心脏,把数据有节奏地泵进阵列,每个 PE 用一次手头的数据再传给邻居——同份数据沿途被反复利用,而不是每个运算都回存储器取一遍。
单个PE通常就是上述的DATAPATH写法:
算矩阵乘法 C = A×B 时,每个单元固定存一个权重 w[k][j](所以叫 weight-stationary,权重静止),激活值 a[i][k] 沿行从左往右流,部分和沿列从上往下流,一个周期每个单元恰好做一次乘加。输入按对角线错拍(skewed)送入,保证正确的 a 和正确的部分和恰好在同一拍相遇;进入稳态后每个周期从阵列底部流出一个结果。阵列整体像一个二维流水线,数据以“波前”形式扫过。
它高效的原因有三条,全都直接来自结构:
数据复用:一个操作数从存储器取出一次,在流过阵列的途中被 N 个 PE 使用,计算/访存比是 O(N)——这正是针对冯·诺依曼瓶颈(访存跟不上计算)设计的。 局部互连:PE 只连上下左右,没有长导线和全局总线,布线短,时钟频率高,天然适合 VLSI/FPGA。 极致规则:只设计一个 PE,然后用 HDL 的 generate 循环平铺 N×N 份,几行代码综合出几万个乘加器。
DATA PATH:数据通路,除了各种控制相关的,比如control unit,都走这条通路。