前言
叠甲:部分使用了AI解释,不保证一定正确
这门课主要是理论课,不存在lab,但是知识点繁多,因此我记录笔记如下。
- 后记:这门课教材大概是:William Stallings 的《Computer Organization and Architecture: Designing for Performance》(中译名《计算机组成与体系结构:性能设计》,Pearson 出版)
第一节课:basic concept and computer architecture.
有四次期中考,平时成绩和期末占比6:4
- ISA:Instruction set architecture.指令集,分为精简指令集(RISC)和复杂指令集(CISC)
- Micro-architecture:
DataPath:数据通路
Controller:控制器
计算机系统的概念:
包含了从汇编到处理器,IO,内存,数据通路/控制器这一块。更底层的digital design和circuit design,transistors 不涉及这段内容。 (接下来是些为什么要学这门课的碎碎念我就跳过了)
数据处理 数据储存 数据移动 计算机控制:以上所有行为的控制 (然后又是一大段历史,懒得记了) embedded system
input unit MICR… output unit.. ALU(Arithmetic logic unit):在处理器内部的逻辑处理器单元,用于加法触发等
第二节课开始有测试。 binary,line by line,address,第四点elona记不得了(笑),大概是common memory:
binary(二进制):计算机里的一切信息——数据也好、程序也好——全都是用二进制表示的。内存里没有“这是数据、那是代码”的天然区分,全都是一串串的 0 和 1。

line by line(逐行存放):程序是指令的序列,写好后被翻译成二进制,一条接一条地存进内存里,就像存数据一样。执行时 CPU 一条一条往外取。

address(地址):内存的每一个格子都有编号,也就是地址。CPU 里有个程序计数器(PC),记着“下一条要执行的指令在哪个地址”,取完一条就加一,所以程序能顺序执行下去。
普林斯顿架构中,数据和程序共享内存。(普林斯顿架构就是冯·诺依曼架构的另一个名字(普林斯顿大学是最早实现它的地方)。它的定义就是:程序和数据放在同一块内存里,走同一条总线。对比的是哈佛架构(Harvard architecture)——程序存一块独立的内存,数据存另一块,比如很多单片机、DSP 就是这么做的。)
ALU Interface(接口)的概念 Bottle neck(瓶颈),指出总线/处理器等的宽带/计算频率中最弱的部分会限制整体的发挥 virtual port,virtual memory
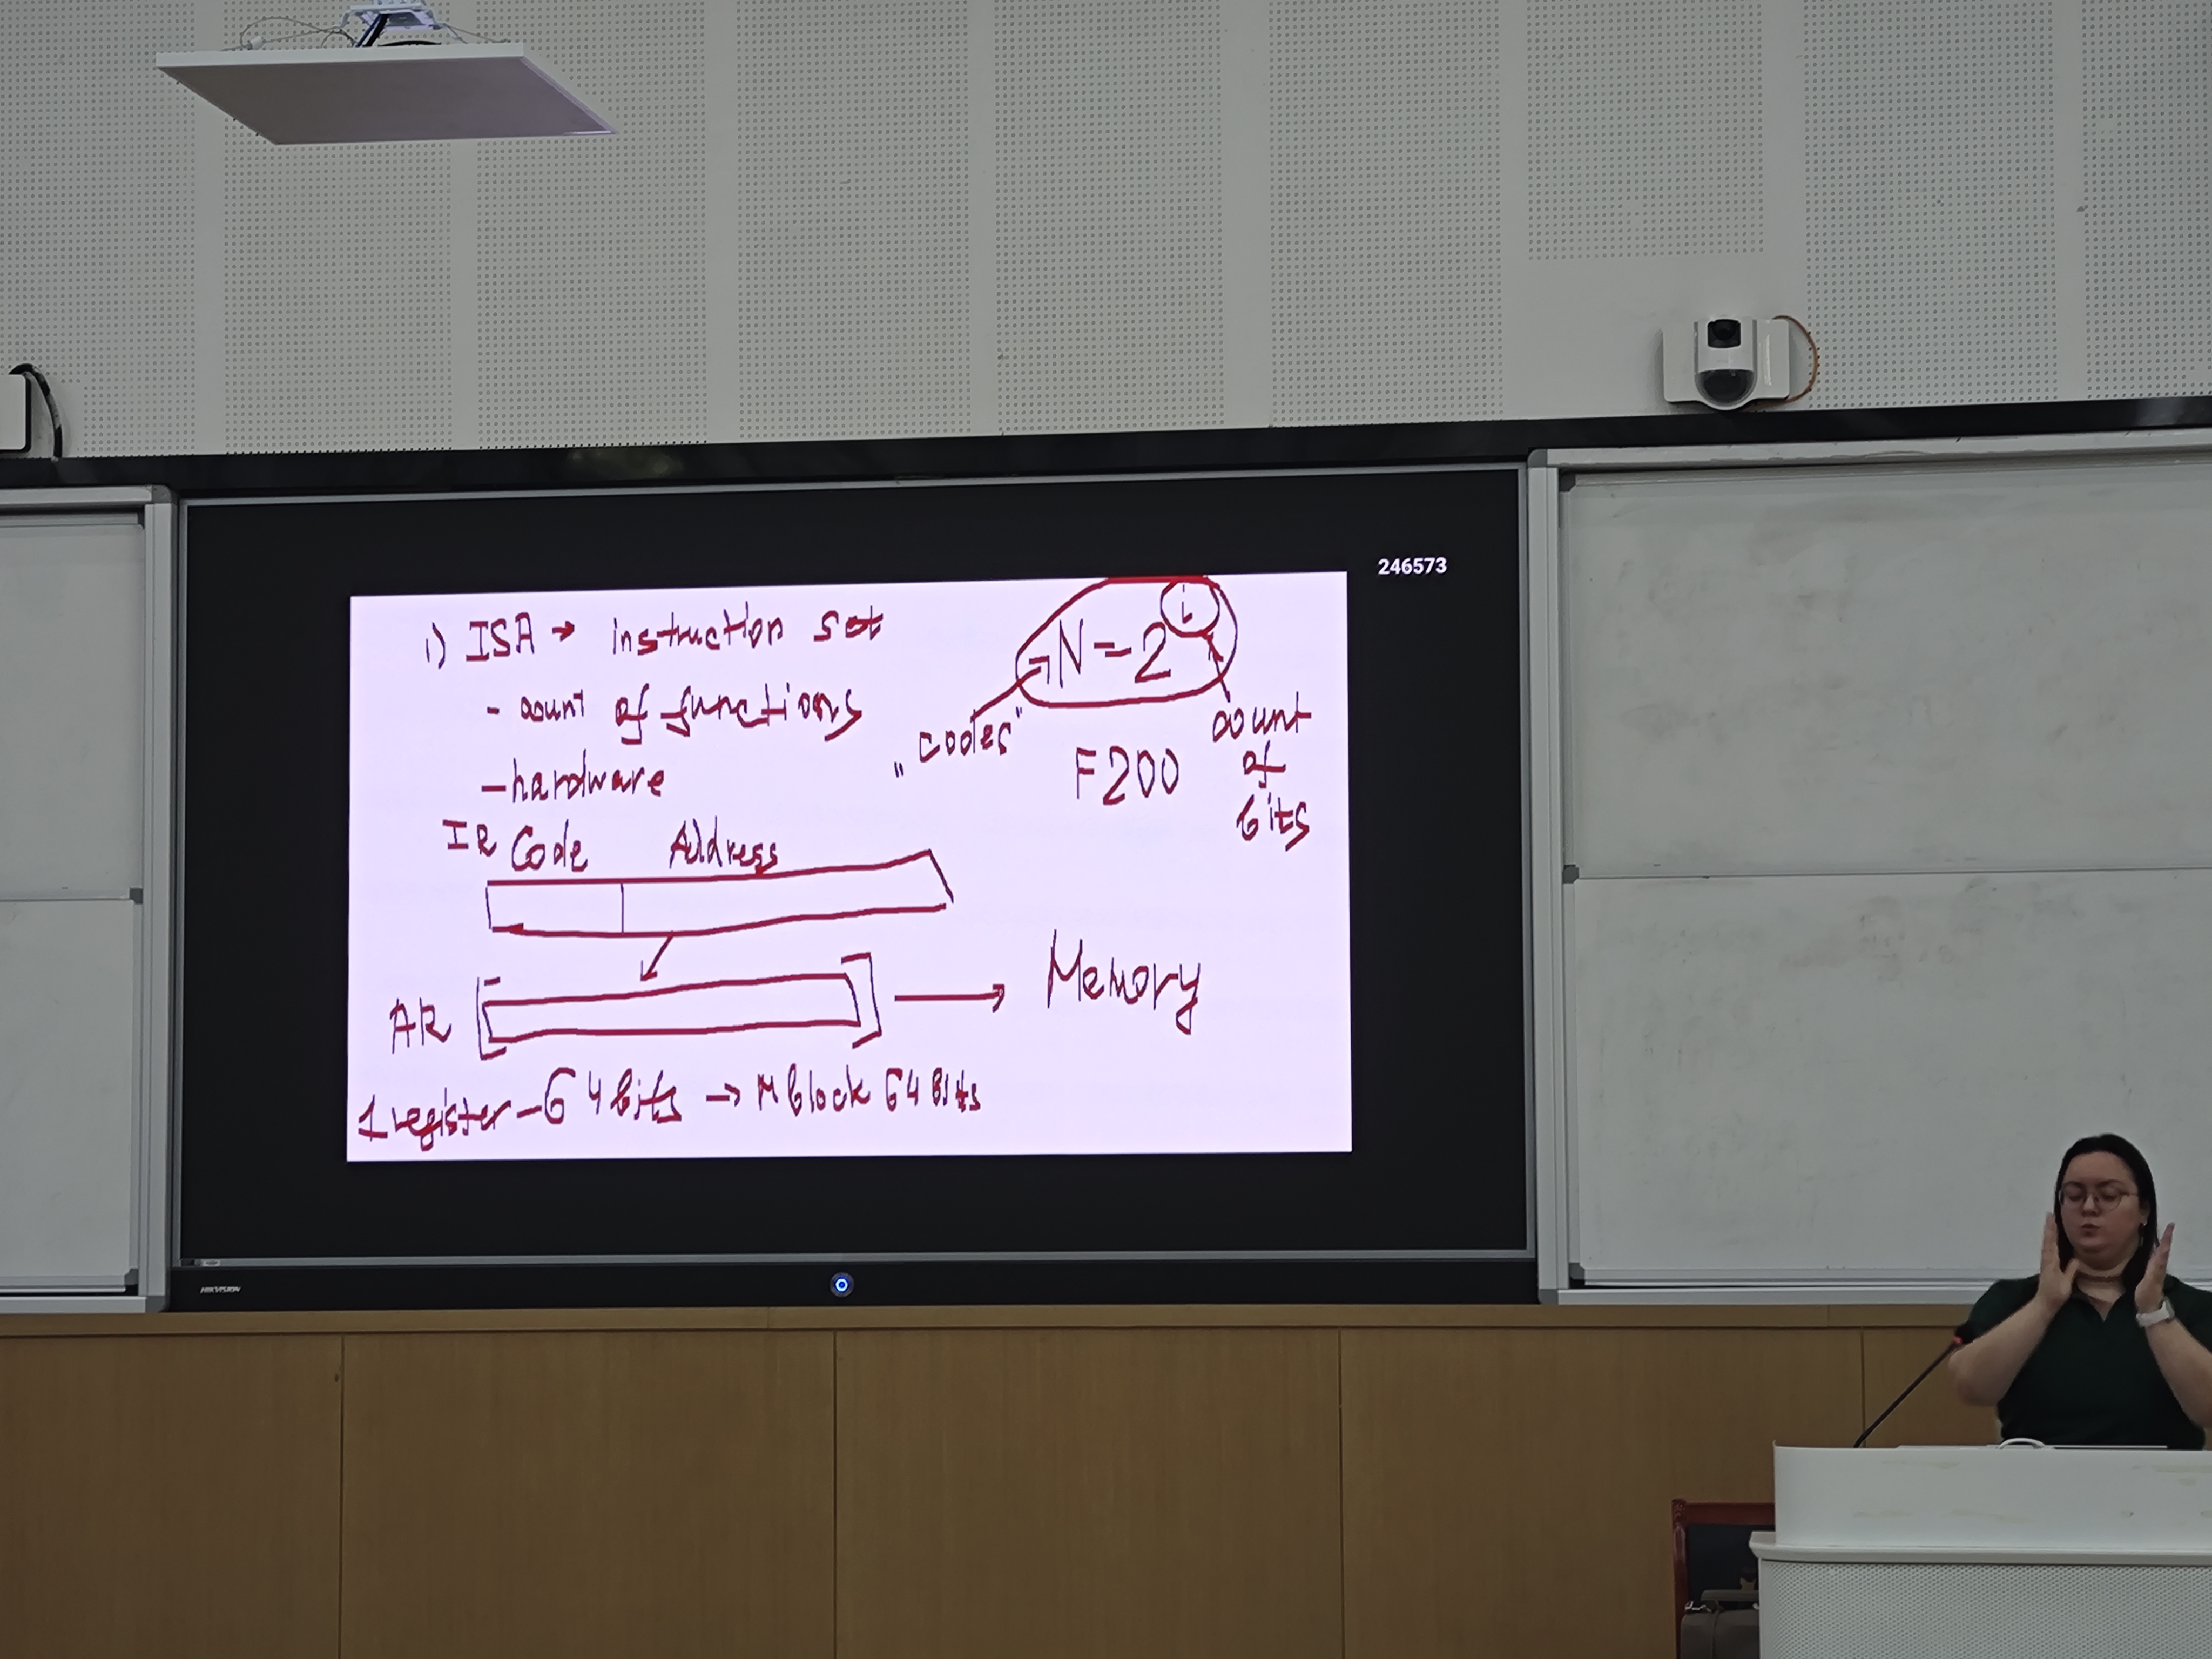 这里elona画了一张图来表示指令是怎么写的
- “IR” 和 “AR”
IR(Instruction Register,指令寄存器):CPU 从内存取出一条指令后,先放进 IR,硬件再把它的 Code 段和 Address 段拆开。 AR(Address Register,地址寄存器):拆出来的地址段被送进 AR,AR 指向内存,按这个地址去取数据——所以图里箭头从 AR 画到 Memory。
- ” ISA → instruction set — count of functions — hardware” ISA 的定义:它规定了处理器支持哪些指令(多少种功能),以及由硬件来实现。这是 ISA 和纯硬件设计的分界线。
3.指令格式。 “N = 2^k” 和 “count of bits” “0000”、”F200” 这是举例:把一条 16 位的指令写成十六进制就是 F200,展开成二进制是:
- “Register 64 bits → M block 64 bits” 这是说寄存器和内存数据块宽度一致:寄存器是 64 位,内存一个块(block)也是 64 位,所以一次访存正好搬一个寄存器宽度的数据,不需要拼拆。
所以指令就是指令段+地址段,地址段会被拆分送入AR,然后对其执行指令段的命令。
在进入下半部分之前有个小例子。主要是关于一个灯光控制系统的,也就是红绿灯。要求是能通过按钮变成绿灯,可以红绿灯切换,然后还有倒计时闪烁。然后分析了一下需要的元件(cpu。memory什么的)以及控制流。
然后不知道为什么他又觉得要加入input buffer register(IBR),circuit,amplifier(放大器)
然后引入了中断(虽然我觉得没必要吧,事件驱动+前后台就行了)然后有中断就得有栈stack,然后就得有ROM(只读储存器,这里用了其断电不掉数据的特性)RAM(随机访问内存,就是通常意义上的内存)
最后统计了可能用到的寄存器,总线,等等
- Instruction cycle: Instruction cycle(指令周期)就是 CPU 不断重复的一个固定流程:取出一条指令 → 执行它 → 再取下一条。 具体来说就是以下这张图:
指令有多种表达方式,2进制,16进制,以及助记符(Mnemonic)。 op:operational code操作数
所以,实际上这一段是在建立一个整体的运行概念,指令是从哪里来的,如何执行的,长什么样
在建立这个概念之后,我们就需要逐步分析各个环节的具体过程。
CPU: 输入flag,clock 解码器: 和图灵完备里的一样,这里是个3位解码器
IO:
Memory:
总线(BUS): control line address line data line
点对点传输: 不经过总线的传输,比如多核CPU的核间交流,
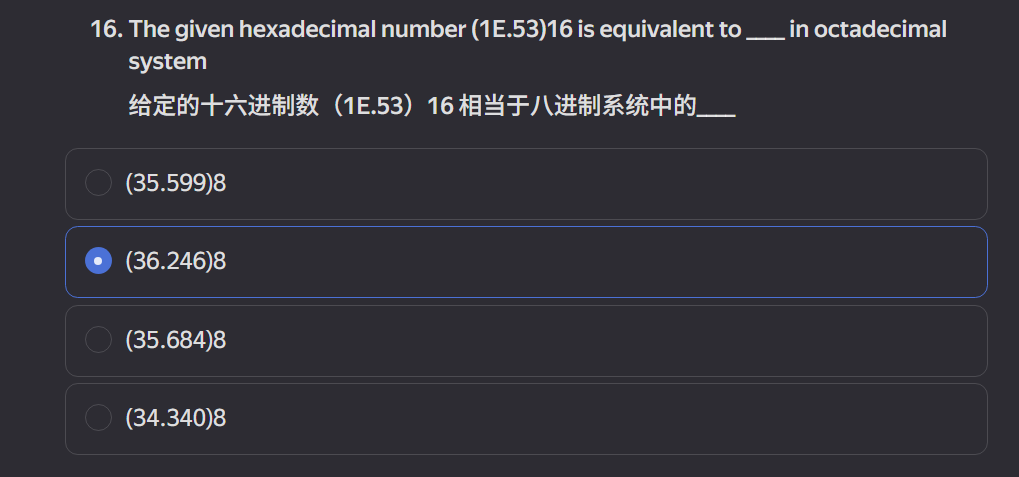 这里要注意这是表示数字的转换,不是大小的转换,也就是没有整数进位之类的东西
cache memory
内存分为primary memory和secondary memory。(主内存和次级内存) 其实就是中文里面内存(通常来说的RAM)和储存(通常来说的ROM或者其他的磁盘)的概念而已( register memory,cache memory on-line mass memory offline bulk memory
后面非常无聊地讲了储存和内存的区别….. 神他妈shark Mashine Счётная машина(俄语“计算机”)——如果你看的是苏联时代的纪录片或翻译教材,электронно-счётная машина(电子计算机)音译过来很容易被写成”shark machine”;
内存是分成虚拟的和真实的,通过内存表来映射到物理内存(为了寻址方便)。 后面讲了缓存到内存的映射,AI是这么解释的:
右边 Memory:
主存,按字(word)编址,每个字 32 位 = 4 字节。字地址 0、1、2…… 每 8 个字(8 × 4B = 32 字节)划成一个块(block):字 0–7 是 block 0,字 8–15 是 block 1,字 16–23 是 block 2。彩色格子表示正在运行的程序访问到的那些字。
左边 Cache:
直接映射缓存,共 8 行(line 0–7)。每行有三个字段:Valid Flag(有效位,标记这一行是否有有效数据)、Block Number(标签,记录当前缓存的数据来自哪个内存块,用来区分“同位置但不同块”的情况)、Value(真正缓存的那 4 字节数据)。 红色箭头:展示了映射关系——内存字 3、字 11、字 19 都指向缓存的第 3 行。 核心规则:直接映射
每个内存块只能放进缓存的固定一行,位置由取模决定:
cache line = (block 地址) mod (缓存行数) 缓存有 8 行,所以字 3、11、19 满足 3 mod 8 = 11 mod 8 = 19 mod 8 = 3,全都被映射到第 3 行。这就是图中三支箭头汇聚到同一行的原因。
这个设计的代价
因为多个内存块共享同一缓存行,就必须靠 Block Number(tag) 来区分“现在这行里存的到底是 block 0、block 1 还是 block 2 的字 3”。CPU 访问时把地址拆成三段:低位是行内偏移(4B 一个字 → 2 位),中间是行号(8 行 → 3 位),剩下的高位是 tag,与缓存行里存的 tag 比较;命中且有效位为 1 才能直接用,否则就要把整块数据从内存换进来,把原来占位置的块挤出去——这就是直接映射缓存最容易发生冲突失效(conflict miss)的原因:哪怕缓存没满,两个轮流访问的地址只要 mod 8 同余,就会不停地互相顶替。
简而言之的话,就是缓存是分行的,每行对应一个固定大小的内存块。CPU为了快速起见每次读取内存都是一块一块取的,这个映射就是为了让你明白CPU索要的内存数据块是否是存在缓存里的那块。为了保证这个是正确的,缓存会以行为单位映射多个块的内存。例如行3对应第三个、第十一个、第十九个块。
当CPU想访问一个地址的时候,首先会去缓存进行查询。原始的内存地址是连续的一系列数字,缓存会对其做处理,例如缓存字地址19:
tag = 10(block 2) index = 011(第 3 行) offset = 11
字 19 在真实内存里占的是字节地址 76–79(19 × 4),它只是个普通的数。
“块结构”是缓存硬件强加给地址的,不是地址自带的
缓存设计者先定下两个参数:一行装多大(比如 64 字节)、一共多少行(比如 512 行)。然后才把任何拿来的地址机械地切三段:
低 log2(64)=6 位 → 行内偏移
中间 log2(512)=9 位 → 行号
剩下的高位 → tag
切法完全由缓存的几何参数决定。同一台机器上,L1 和 L2 的行数、行大小不同,同一份地址会被切成完全不同的三段;如果是全相联缓存(无行号),干脆没有 index 段。所以不是地址“天生”带了块信息,而是缓存拿着尺子去切地址——尺子刻度变了,切出来的块就变了
现在我们CPU依然要找19这个地址的数据,然后19的地址给到了缓存:
缓存将其理解为这块内存要到缓存的line3,然后会开始匹配Tag,如果匹配成功,那么就会把这里的valid flag置为1,接着CPU会开始读。
如果tag不正确,这块内存作废,重新从内存里面读(比如可能这行存的是3或者11的数据块)
自始至终,CPU永远使用原始内存地址,只不过缓存巧妙地实现了以块形式的映射和寻址(当然现代计算机里面多个MMU,会多映射一层,就是前面提到的物理内存变成虚拟内存)
(教材17页有细讲这个)
三级缓存:
为了解决CPU转的太快RAM太慢,我们需要缓存。但是缓存通常来说不够大,所以引入了多级缓存。
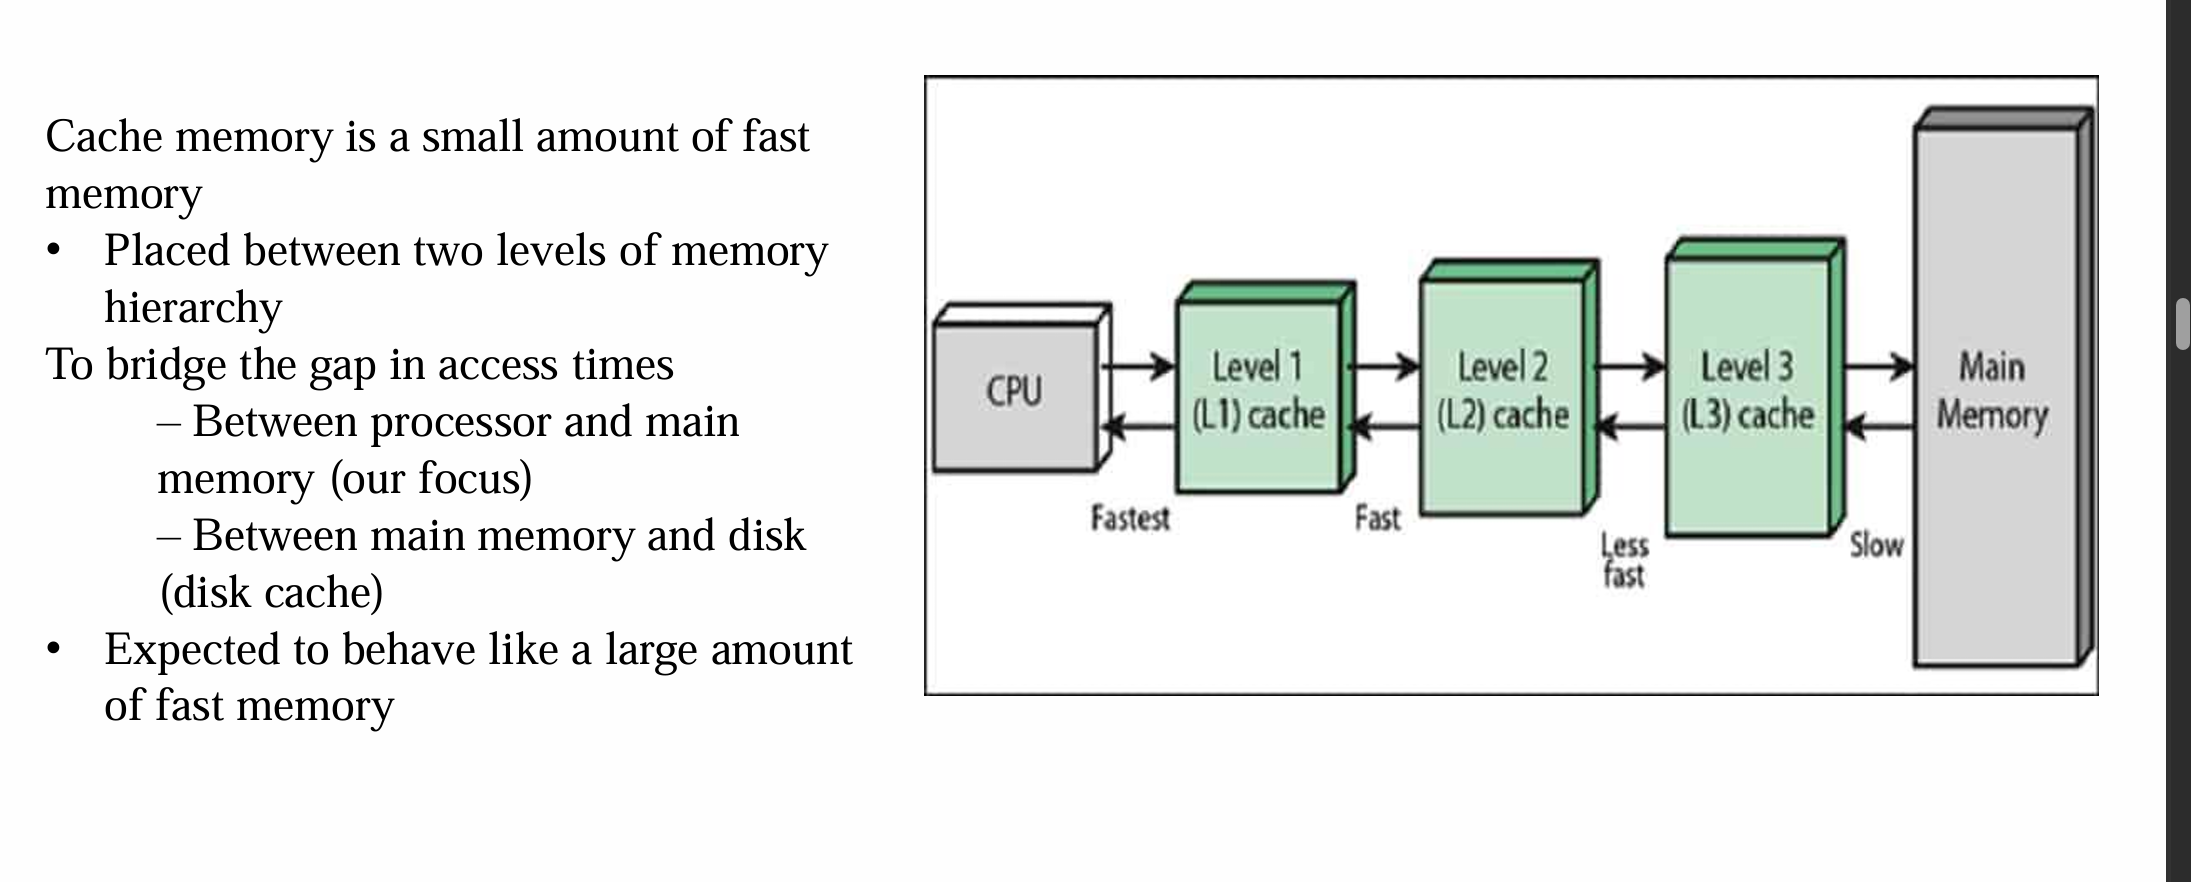 在这张图里,每个缓存都把下一级当成内存看待,因此形成了逐层寻找的机制,最大程度避免了miss的影响。
缓存命中率
- 命中率 h(hit ratio)
定义就是一行字:命中的访问次数 ÷ 总访问次数。把程序跑起来统计所有内存访问,命中占的比例就是 h。课件给的典型值是 0.90–0.97,意思是绝大多数访问都被缓存拦下了,根本轮不到内存出场。
- 缺失率 m = 1 − h
就是命中率的反面,两者互补:命中 95%,缺失就是 5%。有的资料爱用这个口径,本质同一个数。
- 平均访存时间(核心公式)
T = h × T缓存 + (1−h) × T内存 这里的T是时间,也就是平均访问内存的时间是命中率与内存/缓存读取时间的加权和。 最后,“如果有多级缓存,公式要按显然的方式修改”,指的就是上面那种方式:每一级都有自己的平均访存时间,把他们看成一系列的缓存/内存集合体,我们就可以得到:
T = h₁×T₁ + (1−h₁)×h₂×T₂ + (1−h₁)(1−h₂)×h₃×T₃ + …
LRU
缓存满了之后的替换策略。
internal memory(内部储存器)
直译可能会变成内存,但是这个指的不是通常意义上的内存,main memory。这个是在CPU内部的最昂贵的内存。 memory有两种分法:一种是可读写次数来分,一种是通过读写顺序来分:
| 缩写 | 全称 | 中文 | 存取方式 | 读写能力 | 典型代表 |
|—|—|—|—|—|—|
| RAM | Random Access Memory | 随机存取存储器 | 随机 | 读写、易失 | SRAM、DRAM |
| RWM | Read-Write Memory | 读写存储器 | 随机 | 读写、易失 | =RAM 本体 |
| ROM | Read-Only Memory | 只读存储器 | 随机 | 只读、非易失 | 掩膜 ROM |
| RMM | Read-Mostly Memory | 以读为主的存储器 | 随机 | 可改写但很慢、非易失 | EPROM、EEPROM、Flash |
| SAM | Sequential Access Memory | 顺序存取存储器 | 顺序 | 可读写 | 磁带、纸带 |
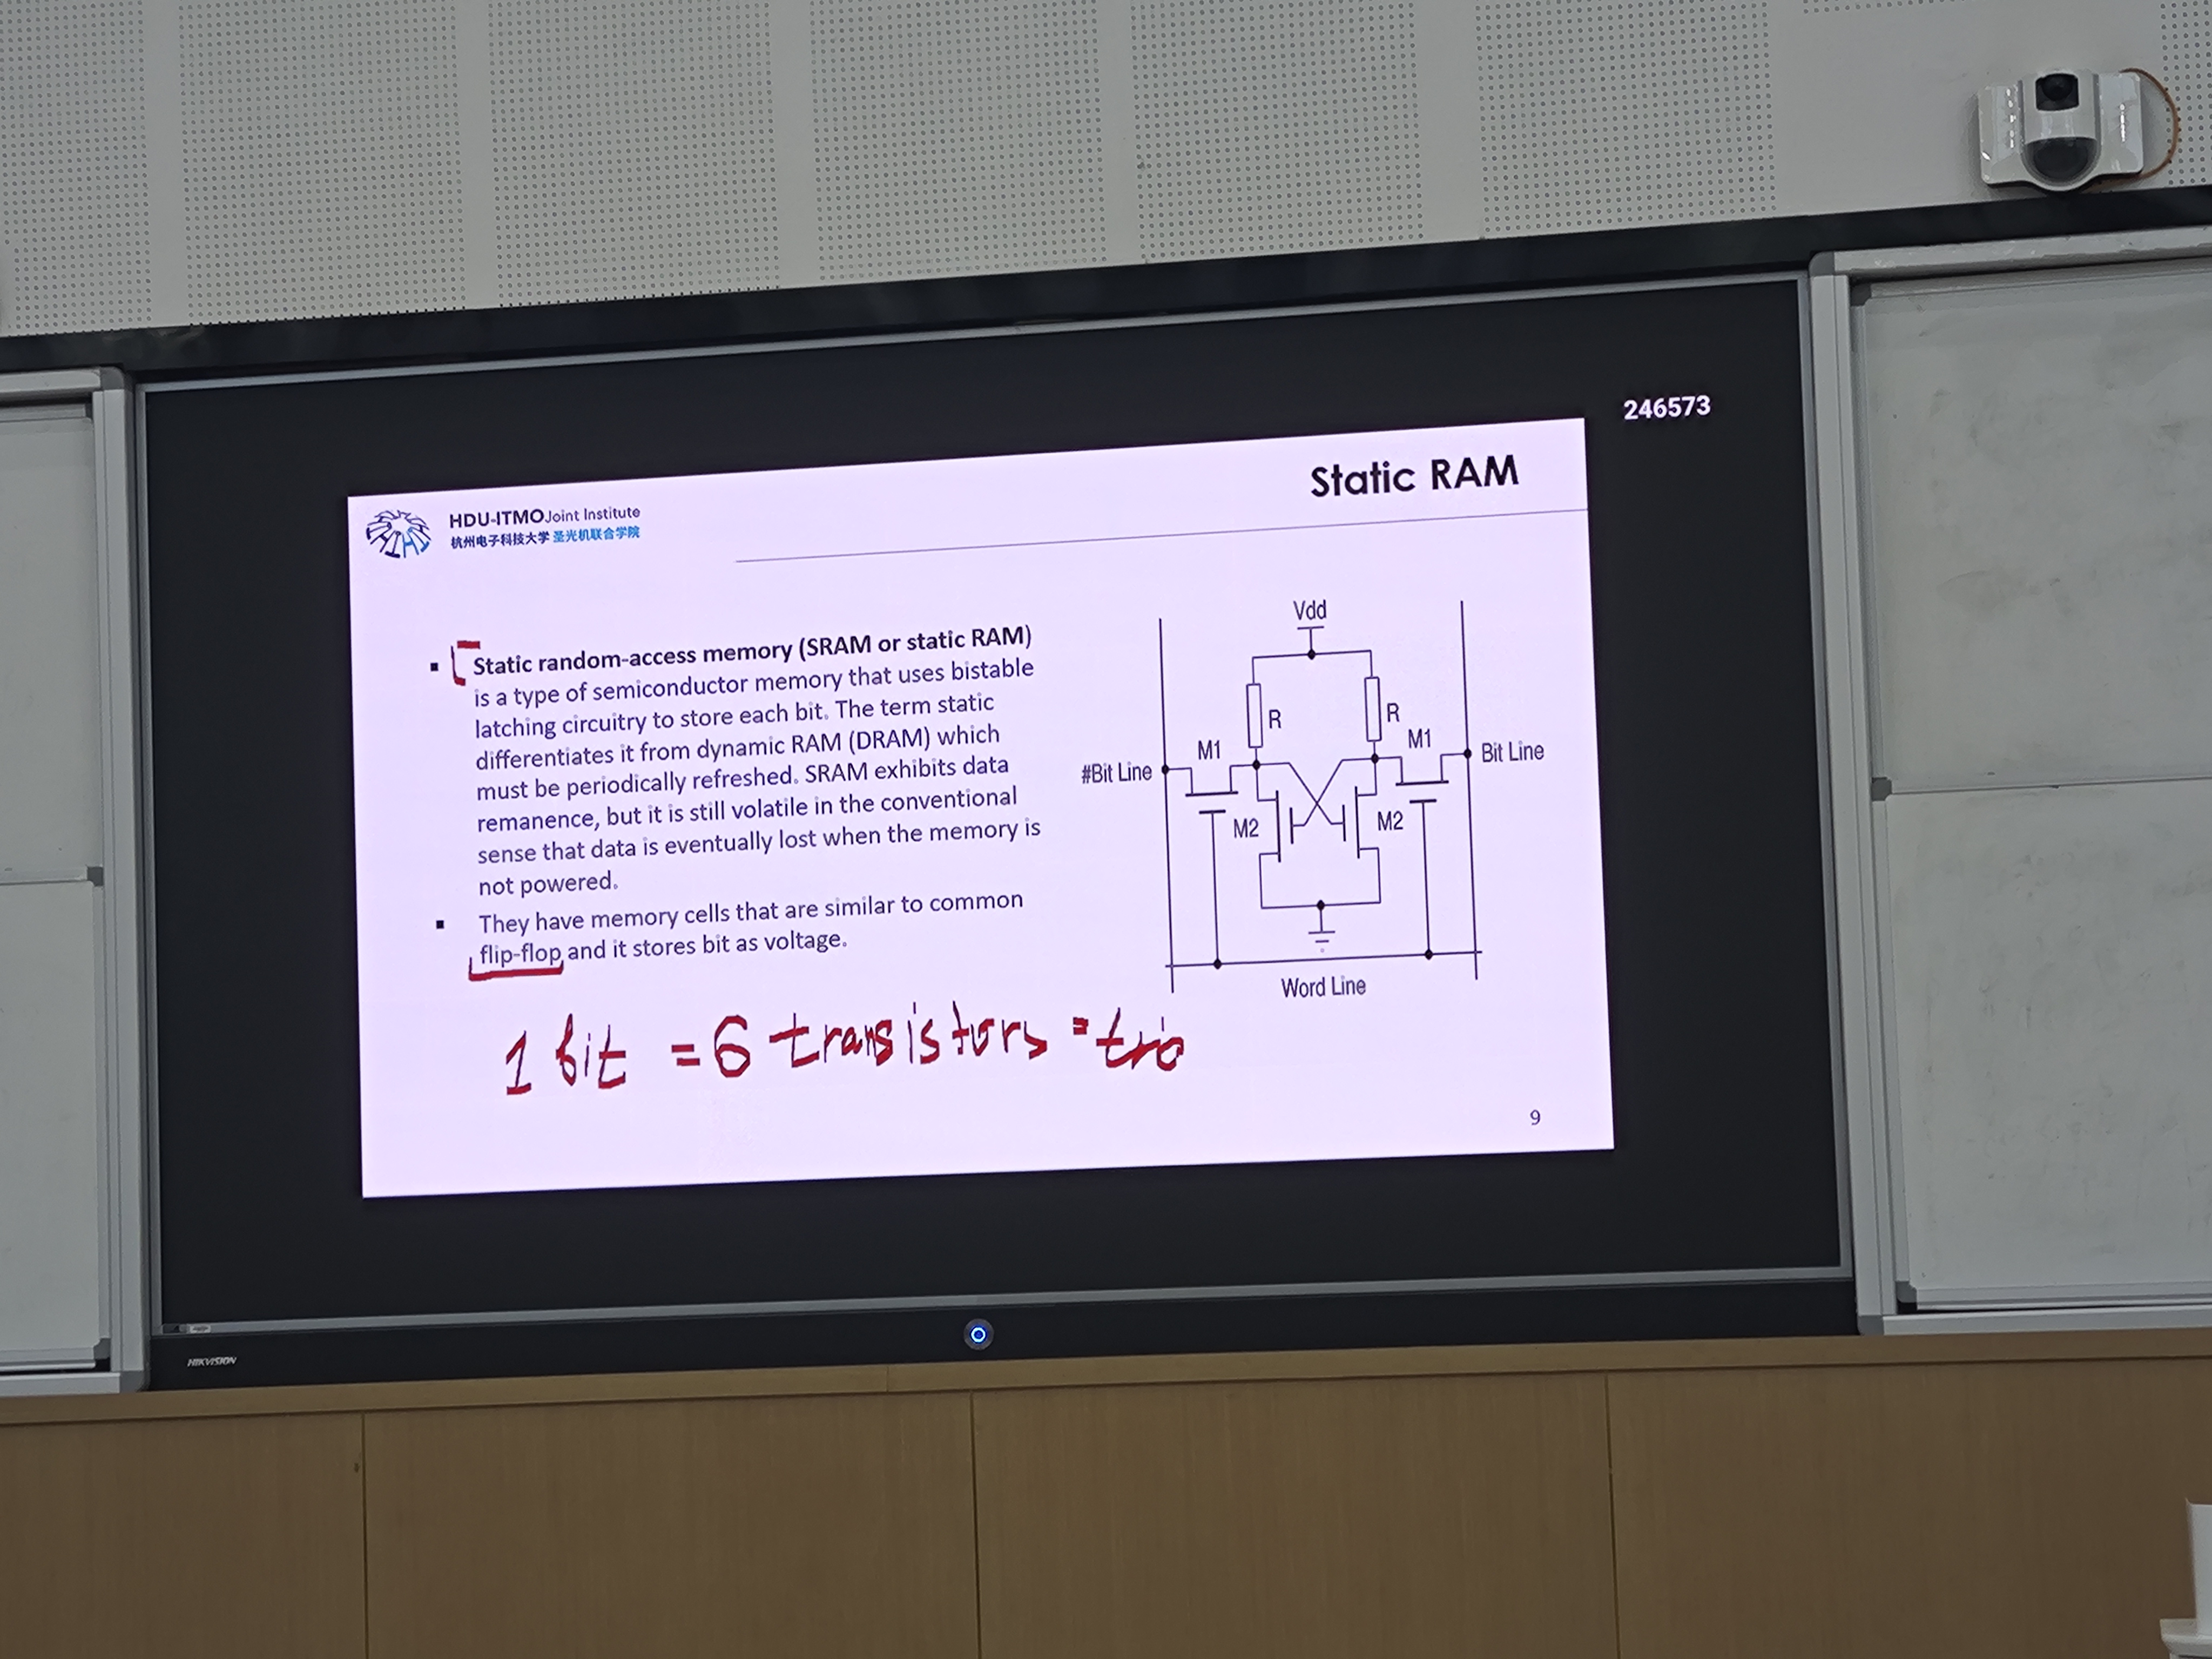 SRAM (Static RAM)的存储单元内部电路:
这个本质上是一个锁存器,它的原理大概要玩图灵完备才能学会。所以我们只要会其是如何储存状态的八股就行了:
对于逻辑1: C1 高电平,C2低电平 T1(transistor 1,后略)T4开启,
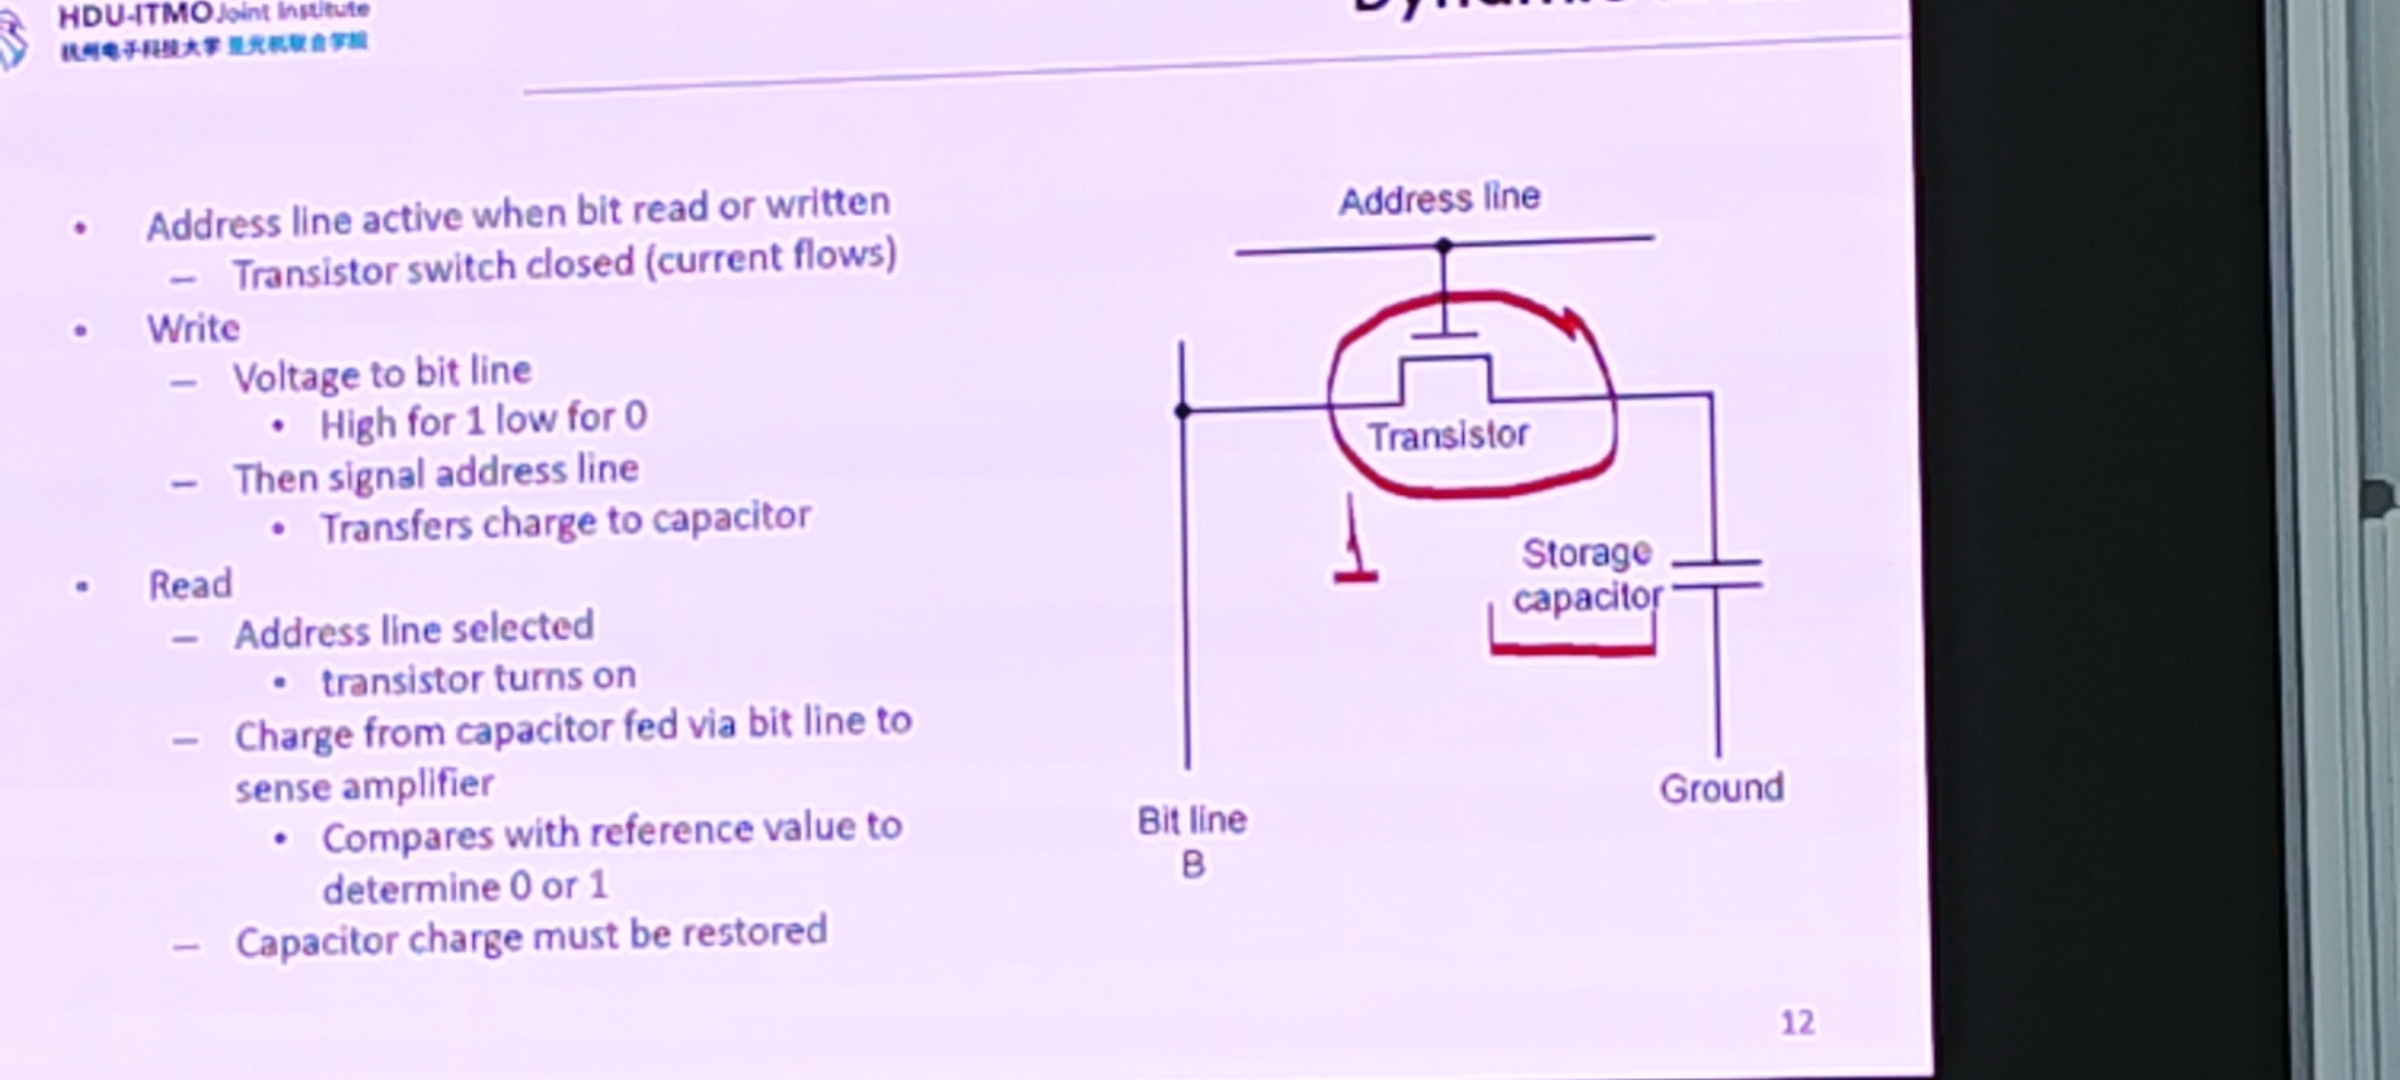 DRAM (dynamic RAM,手机/电脑常用)的存储单元——和 SRAM 的 6 管豪华配置正相对,这里整个单元只有两样东西:1 只晶体管 + 1 个电容(老师红圈圈出来的就是),教科书称为 1T1C 结构
permanent storage(永久性存储)= 非易失存储
- nonvolatile 非易失性(nonvolatile / permanent) DRAM 有 data remanence(数据余留):断电后电荷不会瞬间消失,残留几秒到几分钟——forensics(取证)领域真有“断电后冰袋冷冻内存条再读出密钥”的攻击。但工程分类上它仍算易失,因为不能依赖这个残留
上一张PPT说了:电容会漏电,电荷只撑几毫秒。所以 DRAM 必须在数据漏光之前定期把每一行读出来、放大、写回去,这个例行公事就是刷新。这个过程被称为:
refresh cycle
read cycle
address 11位 但是对于16M的 DRAM,我们有4M*4,显然大于2^11的2048,4M = 2²² 个位置 → 需要 22 位地址,所以我们需要:
multiplexing(分时复用)
同一组 11 根地址线,分两个时钟拍、当两套地址用:
第一拍:送上低 11 位 = Row Address(行地址),同时拉一下 RAS(Row Address Strobe,行选通信号)——芯片把这 11 位锁存进行地址缓存,驱动行译码器,选中一整行; 第二拍:同样的 11 根线改送高 11 位 = Column Address(列地址),拉一下 CAS(Column Address Strobe)——锁进列地址缓存,从刚选中的那一行里挑出对应列的 4 bit,送到数据引脚。
ROW Address COLUMN Address 同时: 刷新是按“行”为单位的——有了行地址就够了,不需要列地址(这叫 RAS-only refresh)。2048 行要在 64 ms 里刷完,就是 64 ms ÷ 2048 ≈ 每 31 µs 刷一行
256Kbyte module organization
1MByte Module Organization
SIMM Module
Erro correction
hard failure
soft erro
detected using hamming error code
汉明码
hamming code就是为了避免电磁辐射导致的位反转产生的(常用于ECC)。它的算法与CRC类似但是排列不同: 数据位和校验位混排,第 1、2、4、8… 位留给校验位,其余位置放数据。以最经典的 Hamming(7,4) 为例——4 个数据位,3 个校验位,共 7 位:
| 位置 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| 内容 | p1 | p2 | d1 | p4 | d2 | d3 | d4 |
关键规则:校验位 p_k 负责所有”位置编号的二进制里第 k 位是 1”的位:
- p1 管位置 1,3,5,7(二进制 xx1)
- p2 管位置 2,3,6,7(二进制 x1x)
- p4 管位置 4,5,6,7(二进制 1xx)
三组覆盖互相重叠,任何一位都恰好被若干组包含。
手算一遍(考试大概率考这个)
数据 1011(d1 d2 d3 d4 = 1 0 1 1),偶校验: 注:⊕ 这个符号指的是模加法,就是加起来然后对 2 取模。
p1 = d1⊕d2⊕d4 = 1⊕0⊕1 = 0
p2 = d1⊕d3⊕d4 = 1⊕1⊕1 = 1
p4 = d2⊕d3⊕d4 = 0⊕1⊕1 = 0
码字:0 1 1 0 0 1 1
假设第 5 位翻转变成了 0 1 1 0 1 1 1。接收端把三组校验重新各算一遍,得到 s1=1, s2=0, s4=1,拼成二进制 (s4 s2 s1) = 101 = 5——出错位置直接被报出来了,翻回去即纠错完成。
这就是汉明码最漂亮的地方:校验位的位置选取使得”哪组校验失败”恰好构成出错位置的二进制地址。每组校验本质上是在回答”出错位置编号在这一位上是不是 1”,三组问完,答案自动拼出来。
扩展到真实内存(ECC 就是这套东西)
校验位数量 k 要满足 2^k ≥ n + k + 1(n 是数据位数):
| 数据位 n | 校验位 k | 总位宽 |
|---|---|---|
| 8 | 4 | 12 |
| 16 | 5 | 21 |
| 32 | 6 | 38 |
| 64 | 7 | 71 |
这就是为什么 ECC 内存条是 72 位宽而不是 64 位——64 数据 + 7 校验 + 1 额外整体校验位。多出来的那一位构成扩展汉明码(SEC-DED):纯汉明码最小距离是 3,能纠 1 位错;若同时错 2 位,syndrome 会指向一个错误的位置,改了反而更错。加上整体奇偶位后最小距离变 4,可以纠 1 位、同时发现 2 位错——double error 只报错不乱改,交给上层处理。
补充两点:
- 开销随字长摊薄:8 位数据要 50% 冗余,64 位只要 12.5%,所以 ECC 按整个字(64 位)编码而不是按字节
- 通用规律:最小距离 d 的编码,纠 t 位错需要 d ≥ 2t+1
logs linux:correctable ECC error
SDRAM(Synchronous DRAM)
把 DRAM 的所有操作都挂到系统总线时钟上的 DRAM——”Synchronous” 同步的是时钟(tick generator)。 这里elona举了个时间的例子,其实是在说DRAM的问题: 控制器送地址、拉 RAS/CAS,然后只能干等,等够 t_AA 才能取数据。问题在于:芯片什么时候好,控制器不可预测,只能按最坏情况傻等,或者反复询问。总线时钟跑得再快也没用,因为内存这头是“自由散漫”的,两边的节拍对不上。
内存控制器不再“发完命令干等”,而是和芯片约定:“第 3 个时钟沿数据准到”(这个约定就是 CL,Cas Latency 等参数)。因为延迟是以时钟周期数明码标价的,控制器拿到了可预测性——发出读命令后,它精确知道数据哪一拍回来,中间这几拍就可以去干别的:发出下一个命令、访问另一个 bank……流水线就转起来了。这就是为什么 SDRAM 的有效带宽远超异步 DRAM:不是单次变快了,是等待被填满了。
给一个起始地址后,后续数据每个时钟沿自动吐一个,连发一串(比如一次 8 个字),这个称为burst,和DMA里面那个概念一样,利于Cache。
CAS Latency(CL)
DDR SDRAM 这个是以上的升级,在上升沿和下降沿都工作。
external memory
这块通常称之为储存。磁带,磁盘,光盘,SD卡都属于这个范畴。
这种内存通常可以在离电的情况下长期储存
RAID:(Redundant Array of Independent Disks,独立磁盘冗余阵列)指用多个物理磁盘组成一个阵列,对操作系统而言呈现为单个逻辑磁盘,数据分布在阵列的各物理盘上,并用部分容量存储冗余校验信息,使得某块盘故障时数据可恢复。通常分为RAID1345这几种:
| 级别 | 名称 | 冗余方式 | 特点 | 最少盘数 |
|——|——|———-|——|———-|
| RAID 0 | 非冗余分条 | 无 | 不是”真”RAID,只为提速;坏一块全丢 | 2 |
| RAID 1 | 镜像 | 每块盘一块副本盘 | 可靠性最高,容量利用率 50% | 2 |
| RAID 2 | 汉明码冗余 | 位级分条 + 一个专门的汉明校验盘(ECC) | 可纠正一位错,现已不用 | 3 |
| RAID 3 | 位交叉奇偶校验 | 位/字节级分条 + 1 块专用校验盘 | 所有盘并行访问,只检错不纠错 | 3 |
| RAID 4 | 块交叉奇偶校验 | 块级分条 + 1 块专用校验盘 | 支持独立读,但校验盘是写瓶颈 | 3 |
| RAID 5 | 块交叉分布式校验 | 块级分条,校验分散到所有盘 | 消除校验盘瓶颈,最常用 | 3 |
| RAID 6 | 双重冗余 | P+Q 双校验(Reed-Solomon 码) | 可同时容忍 2 块盘故障 | 4 |
HHD:HDD(Hard Disk Drive,机械硬盘/硬磁盘驱动器)
机械硬盘由head磁头,track磁道,width宽度,gap和sector扇区组成
- sector 扇区 磁道分段,最小读写单元,传统 512 B
-
Gap(间隙) 磁道上不记录数据的空白间隔,起分隔和缓冲作用:
扇区间隙:分隔相邻扇区
扇区内部:扇区结构 = 前导码(同步/地址信息)+ 数据(512 B)+ ECC 校验码,各字段之间也有间隙 -
Width(这里指磁道宽度 Track Width) 每个同心圆磁道的物理宽度:
磁道越窄,同样半径内能容纳的磁道越多 → 道密度(TPI,每英寸磁道数)越高 → 容量越大。 但磁道太窄要求磁头定位更精确,且容易受相邻磁道干扰 (此外还有个platter表示一块磁盘片)
CAV(Constant Angular Velocity,恒定角速度) 指磁盘以固定转速旋转(如 7200 rpm),每个磁道上的扇区数相同。
由此带来的特点:
每个磁道容量一样,但外圈磁道周长更长 → 外圈的位密度更低,外圈空间被浪费了
换磁道读写时不用调速,控制电路简单 → 机械硬盘普遍采用
对比 CLV(恒定线速度):CD 光盘用的方案,内外圈线速度一致(位密度处处相同),但转速要随磁头位置变化,适合顺序读整张光盘
- Seek Time
寻道时间
磁头移动到目标磁道的时间,平均约 5–10 ms - Rotational Latency
旋转延迟
目标扇区转到磁头下方,平均为半圈:60/(2×RPM) 秒 - Access Time
存取时间
寻道时间 + 旋转延迟(定位数据的时间) - Transfer Time
传输时间
数据量 ÷(转速 × 每道容量) - Command Overhead
命令开销
控制器解析命令的时间,通常忽略不计 - RPM
转速
每分钟转数,常见 5400 / 7200 / 10000 / 15000
磁盘IO时间
CPU进行一次IO需要:
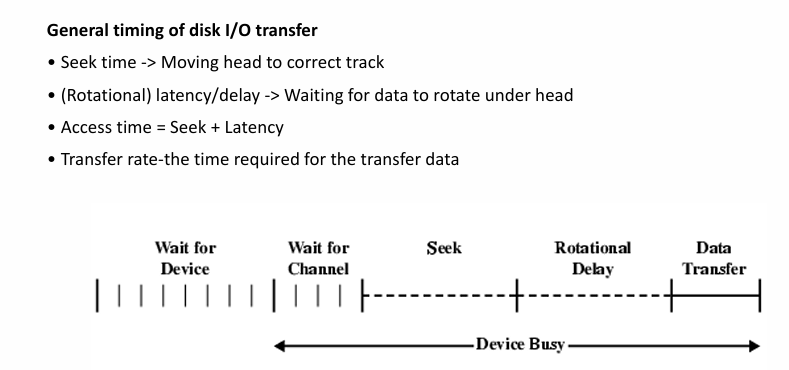
-
Wait for Device(等待设备) 磁盘可能正在处理别的请求,你的请求只能在队列里排队。这段时间磁盘没在为你服务。
-
Wait for Channel(等待通道) CPU 到磁盘之间的 I/O 通道/总线被占用,还得等通道空闲才能下达命令。
-
Seek(寻道) 音圈电机驱动磁头臂移动,从当前磁道移到目标磁道。这是机械动作,是最耗时的部分(毫秒级)。
-
Rotational Delay(旋转延迟) 磁头到位后,还要等目标扇区转到磁头正下方。平均等半圈:60/(2×RPM)。如 7200 rpm 的盘 ≈ 4.17 ms。
-
Data Transfer(数据传输) 盘片继续旋转,磁头把扇区数据读出(或写入),耗时 = 数据量 ÷ 磁盘传输速率。 设备忙的时间就是除了1之外的时间。
功能上磁盘属于存储层次(memory hierarchy,和内存一起构成“寄存器-缓存-内存-磁盘”的金字塔),结构上却挂在 I/O 系统里(靠 I/O 模块访问)。因为它俩访问方式完全一样:都是“给定地址读/写数据”,所以逻辑上算存储;但它速度慢、挂在控制器后面,所以物理上走 I/O 通路
IO设备
由于外部输入输出设备的内存大小,宽带,编解码方式不一致性,因此不能直连总线,需要经过I/O controller或者I/O Bus。 I/O controller的组成是:控制逻辑(control logic)+ 寄存器组(数据寄存器、控制寄存器、状态寄存器)+ 数据缓冲(buffer),外加两个接口——朝上的总线接口和朝下的设备接口 它主要负责:一台/一类特定的设备——把总线上通用的读写命令翻译成这种设备才懂的专属操作,比如SPI,I2C I/O Bus是一种更慢的总线,它主要负责:把所有设备(的控制器)连到 CPU/芯片组上,为多种外设提供一条公共的、共享的传输通路。关键词是 all/multiple devices / common path。
IO设备有以下功能:
- Control & Timing.
- CPU Communication.
- Device Communication.
- Data Buffering.
- Error Detection
经过这些抽象的隔离,CPU可以把这些五花八门的外设都统一为一种形式,它只要知道:每个外设对应的 I/O 模块/控制器的地址(端口号或内存映射地址)——也就是“往哪个地址的寄存器写命令、读写数据、读状态”。所有设备都统一成了“总线上一段可读写的地址空间”
计算机的通信可以分为内部Intra(分为internal的内部设备和external的如IO设备)和外部Inter通信(两台计算机之间通信)
当CPU想使用外设的时候,它必须经过这个流程:
反过来,外设想知会CPU的时候:
据此,我们引出了memory mapped IO的概念:
这通常依赖反复轮询,所以我们引入了中断的概念:
又因为中断之间有重要性区分,因此不同外设的中断,外设内部的中断都有一个优先级表,就如图中的一样,一级套一级有各种优先级的中断表。
如何实现中断:
| 方案 | 谁来找“是谁” | 优先级怎么定 | 痛点 |
| — | — | — | — |
| 每设备一根线 | 不用找,线即身份 | 硬件天然区分 | 耗引脚,设备数受限 |
| Software poll | CPU 软件逐个查 | 查询顺序决定 | 慢,轮询又回来了 |
| Daisy chain | ACK 沿硬件链传递 | 物理位置决定 | 链尾设备可能被“饿死” |
| Bus Master | 设备先仲裁总线 | 仲裁机制决定 | 逻辑最复杂 |
当然这些问题最终被解决了,PCI Express 采用了MSI(Message Signaled Interrupts,消息信号中断):设备不再拉电平线,而是往一个约定的内存地址发一次普通的写事务,写操作的目标地址本身就编码了“我是谁、我是什么中断”。没有共享线、没有菊花链、没有仲裁,一台设备可用的中断数成百上千.
但是每次读写IO依然还是很占用CPU,因此我们设想能否绕过内存直接把数据喂给CPU,不需要经过内存和层层中断,仲裁。
DMA由此而生。
早期的DMA,比如PPT中的这个,只负责替CPU执行搬运指令,并且要占用总线。
| 信号 | 全称 | 谁发给谁 | 意思 |
| — | — | — | — |
| DREQ | DMA request | 磁盘控制器 → 8237 | “我有一批数据要搬” |
| HRQ | HOLD request | 8237 → CPU | “请把总线让给我” |
| HLDA | HOLD acknowledge | CPU → 8237 | “行,总线归你了”(CPU 引脚置为高阻态,图里那几个圆点开关断开就是表示 CPU 从总线上“下车”) |
| DACK | DMA acknowledge | 8237 → 磁盘控制器 | “选你了,上数据线吧” |
IO Channel
这段讲的是I/O设备的发展史。其实根据前面的内容,我们也能大概了解到: CPU 直接控制外设——没有模块的理想化起点,现实中几乎不存在(CPU 会被外设拖死); 加入 I/O 模块 + 程序查询 I/O(无中断)→ 就是你那页 PIO 和键盘 516/517 例程; 同样结构,引入中断,CPU 不必空等 → 中断识别那页(“谁举的手?”); I/O 模块获得 DMA 能力,整块搬运只在开头结尾惊动 CPU → 8237 那页; I/O 模块升级为专职处理器,拥有一套为 I/O 定制的指令集 → 这就是 I/O Channel(通道); I/O 模块有自己的本地内存,本身就是一台计算机,可以统管一大群设备,CPU 几乎不参与。 贯穿六步的主线只有一句话:CPU 的参与度逐级递减,I/O 模块的智能逐级递增——每一代设计者都在问“这件事能不能别劳烦 CPU”。 最终,I/O设备走向了自己独立的内存,处理器和总线,越来越像一个外部的小计算机。
流水线架构和多核架构
fetch-decode-execute-cycle(前面提到过的)
指令可以被细分为各种micro-instruction的组合。
机器指令  ADD R1, R2            ← 汇编/机器码层面看到的东西
  └─ 指令周期阶段  FI→DI→CO→FO→EI→WO   ← 流水线的切法,每级至少占一拍
       └─ 微操作 (micro-operations)     ← 一拍内发生的一组寄存器传输
            └─ 微指令 (microinstruction) ← 控制存储器里驱动这些微操作的控制字
FSM
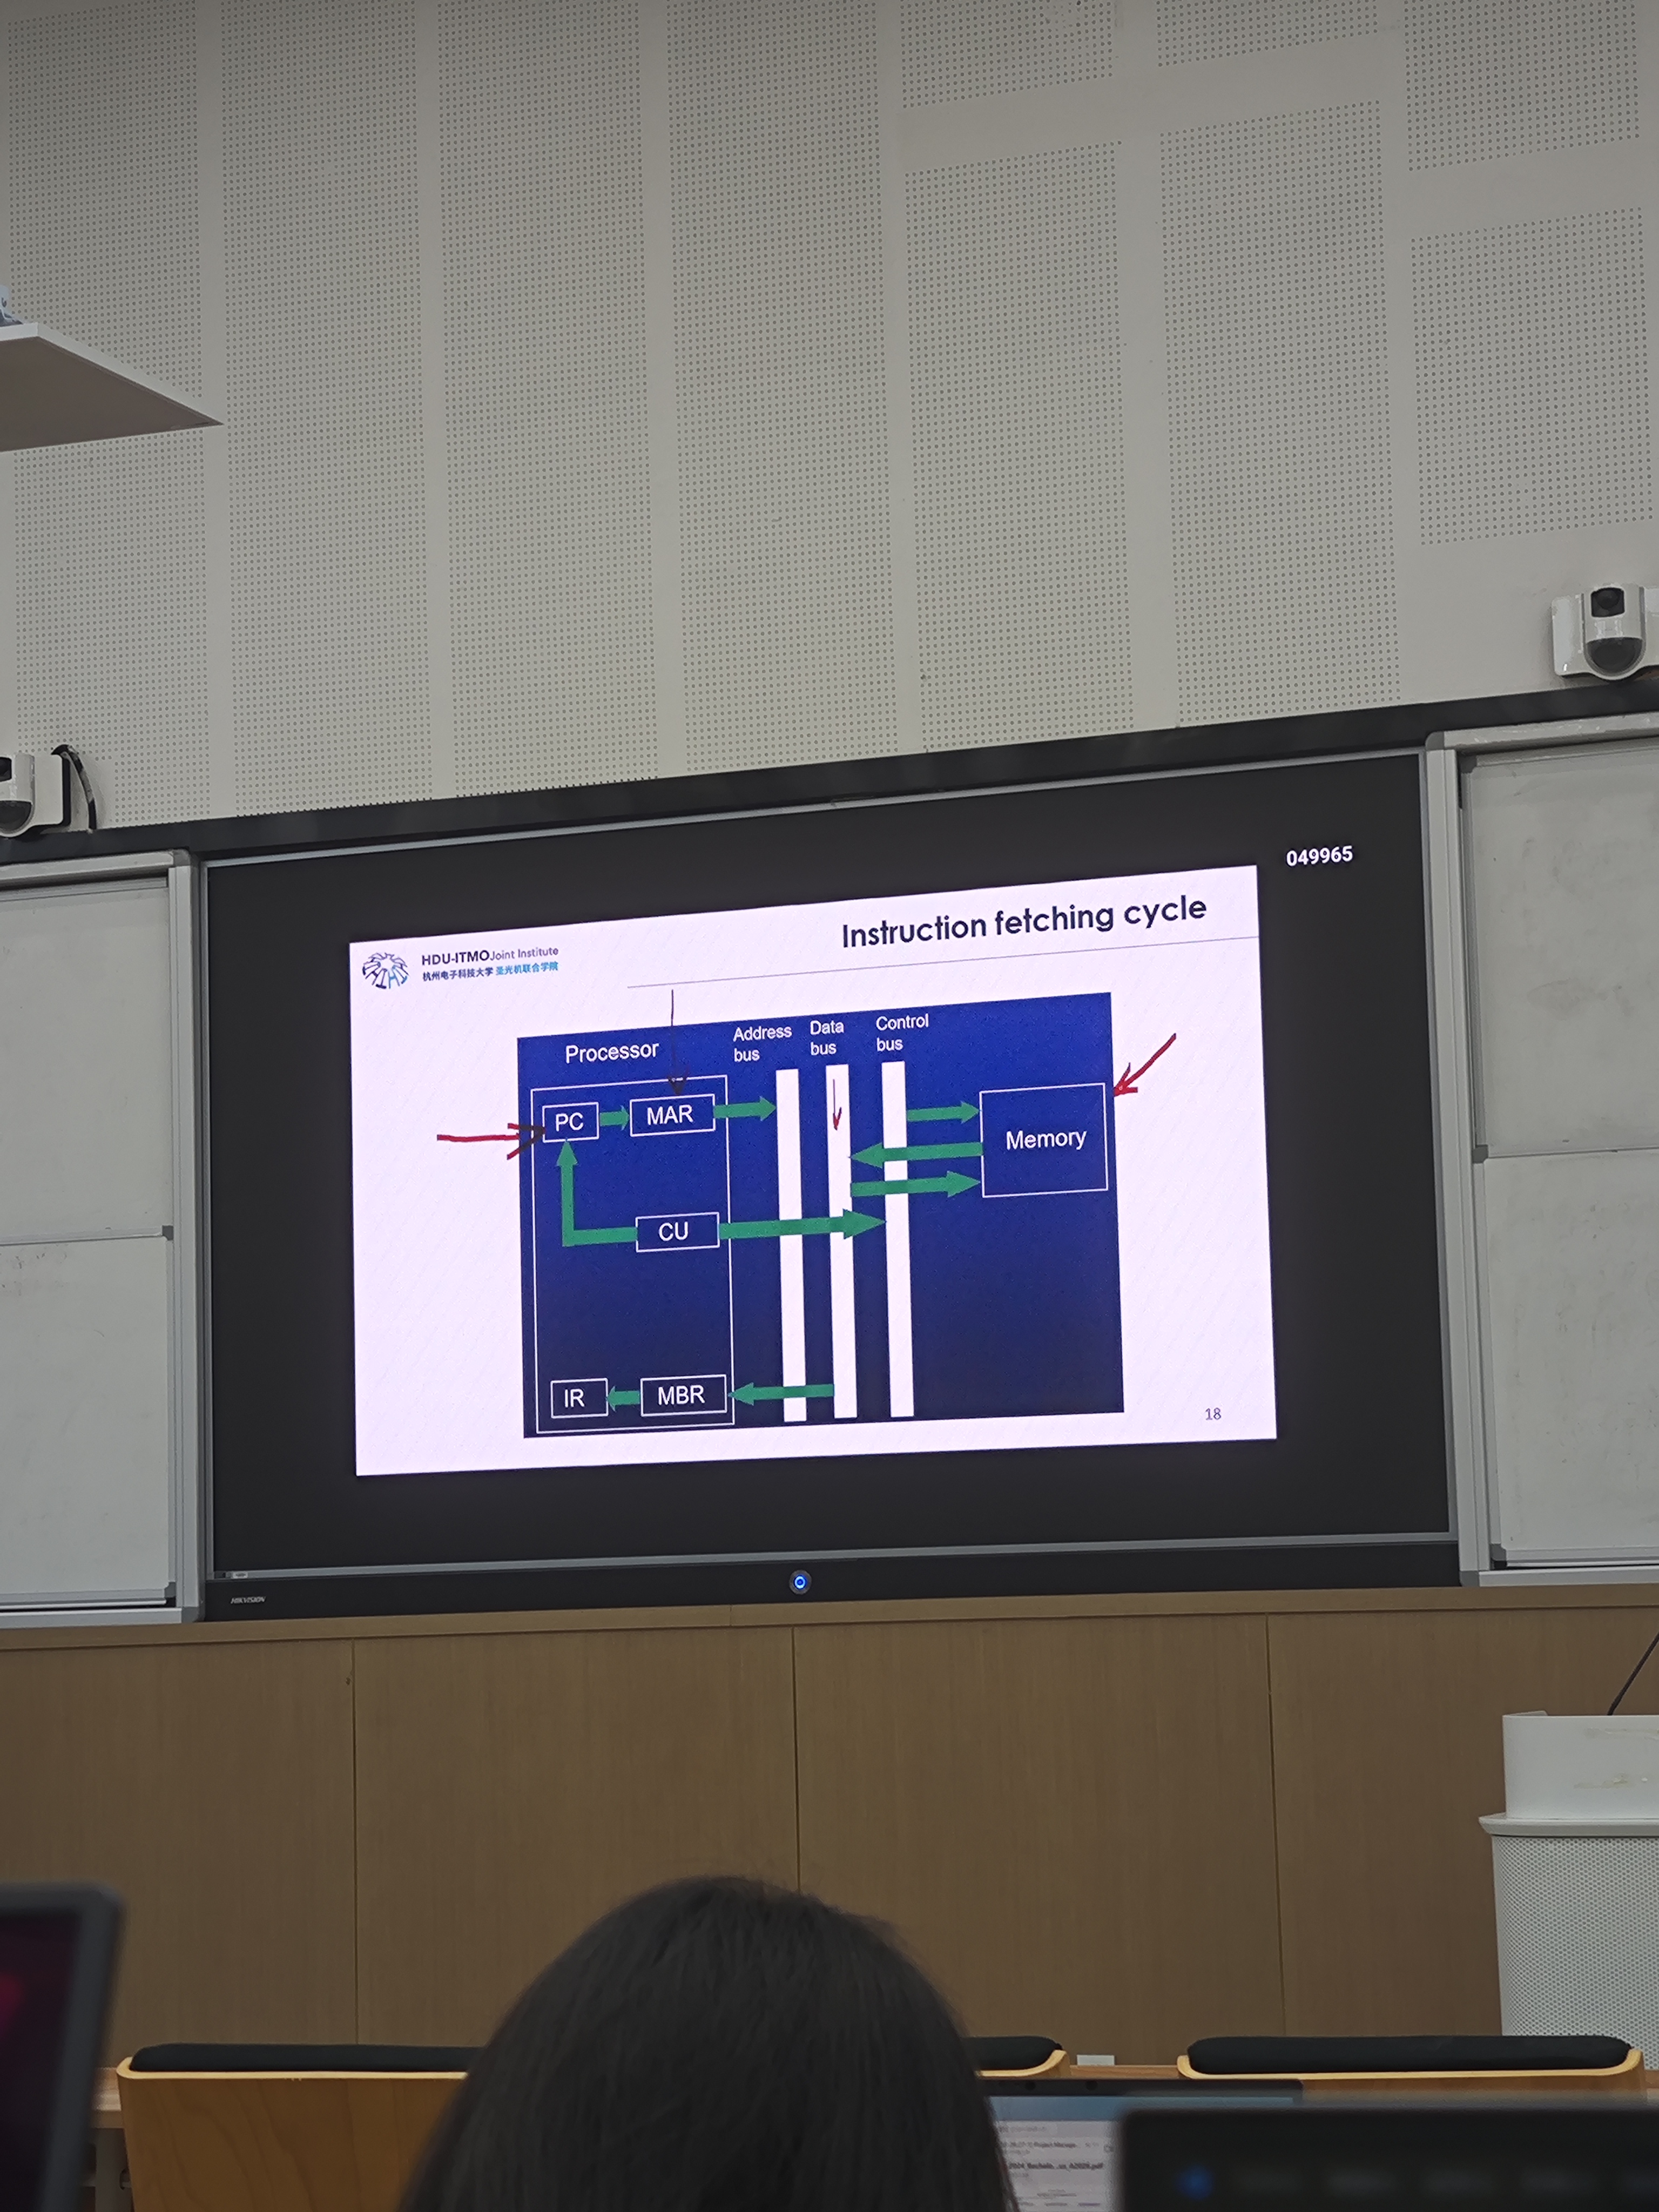 这是 Stallings 教材里很经典的取指周期数据流图(Data Flow, Instruction Fetch),画的是 CPU 从内存里取出一条指令时,数据在寄存器和总线之间怎么一步步流动。
| 缩写 | 全称 | 作用 |
| — | — | — |
| PC | Program Counter 程序计数器 | 存“下一条要取的指令的地址” |
| MAR | Memory Address Register 地址寄存器 | 要访问的内存地址先放到这里,再送上地址总线 |
| MBR | Memory Buffer Register 数据寄存器 | 从内存读出来(或要写进去)的数据先落在这里 |
| IR | Instruction Register 指令寄存器 | 存当前正在处理的那条指令,供译码执行 |
| CU | Control Unit 控制单元 | 发号施令的:发读/写命令、让 PC 自增等 |
图里很容易看出,PC在干活的时候,MBR啊MAR什么的都在摸鱼。为了让第一条指令执行的时候第二条指令就开始,我们发明了指令流水线:
6 级流水线时序图(timing diagram)
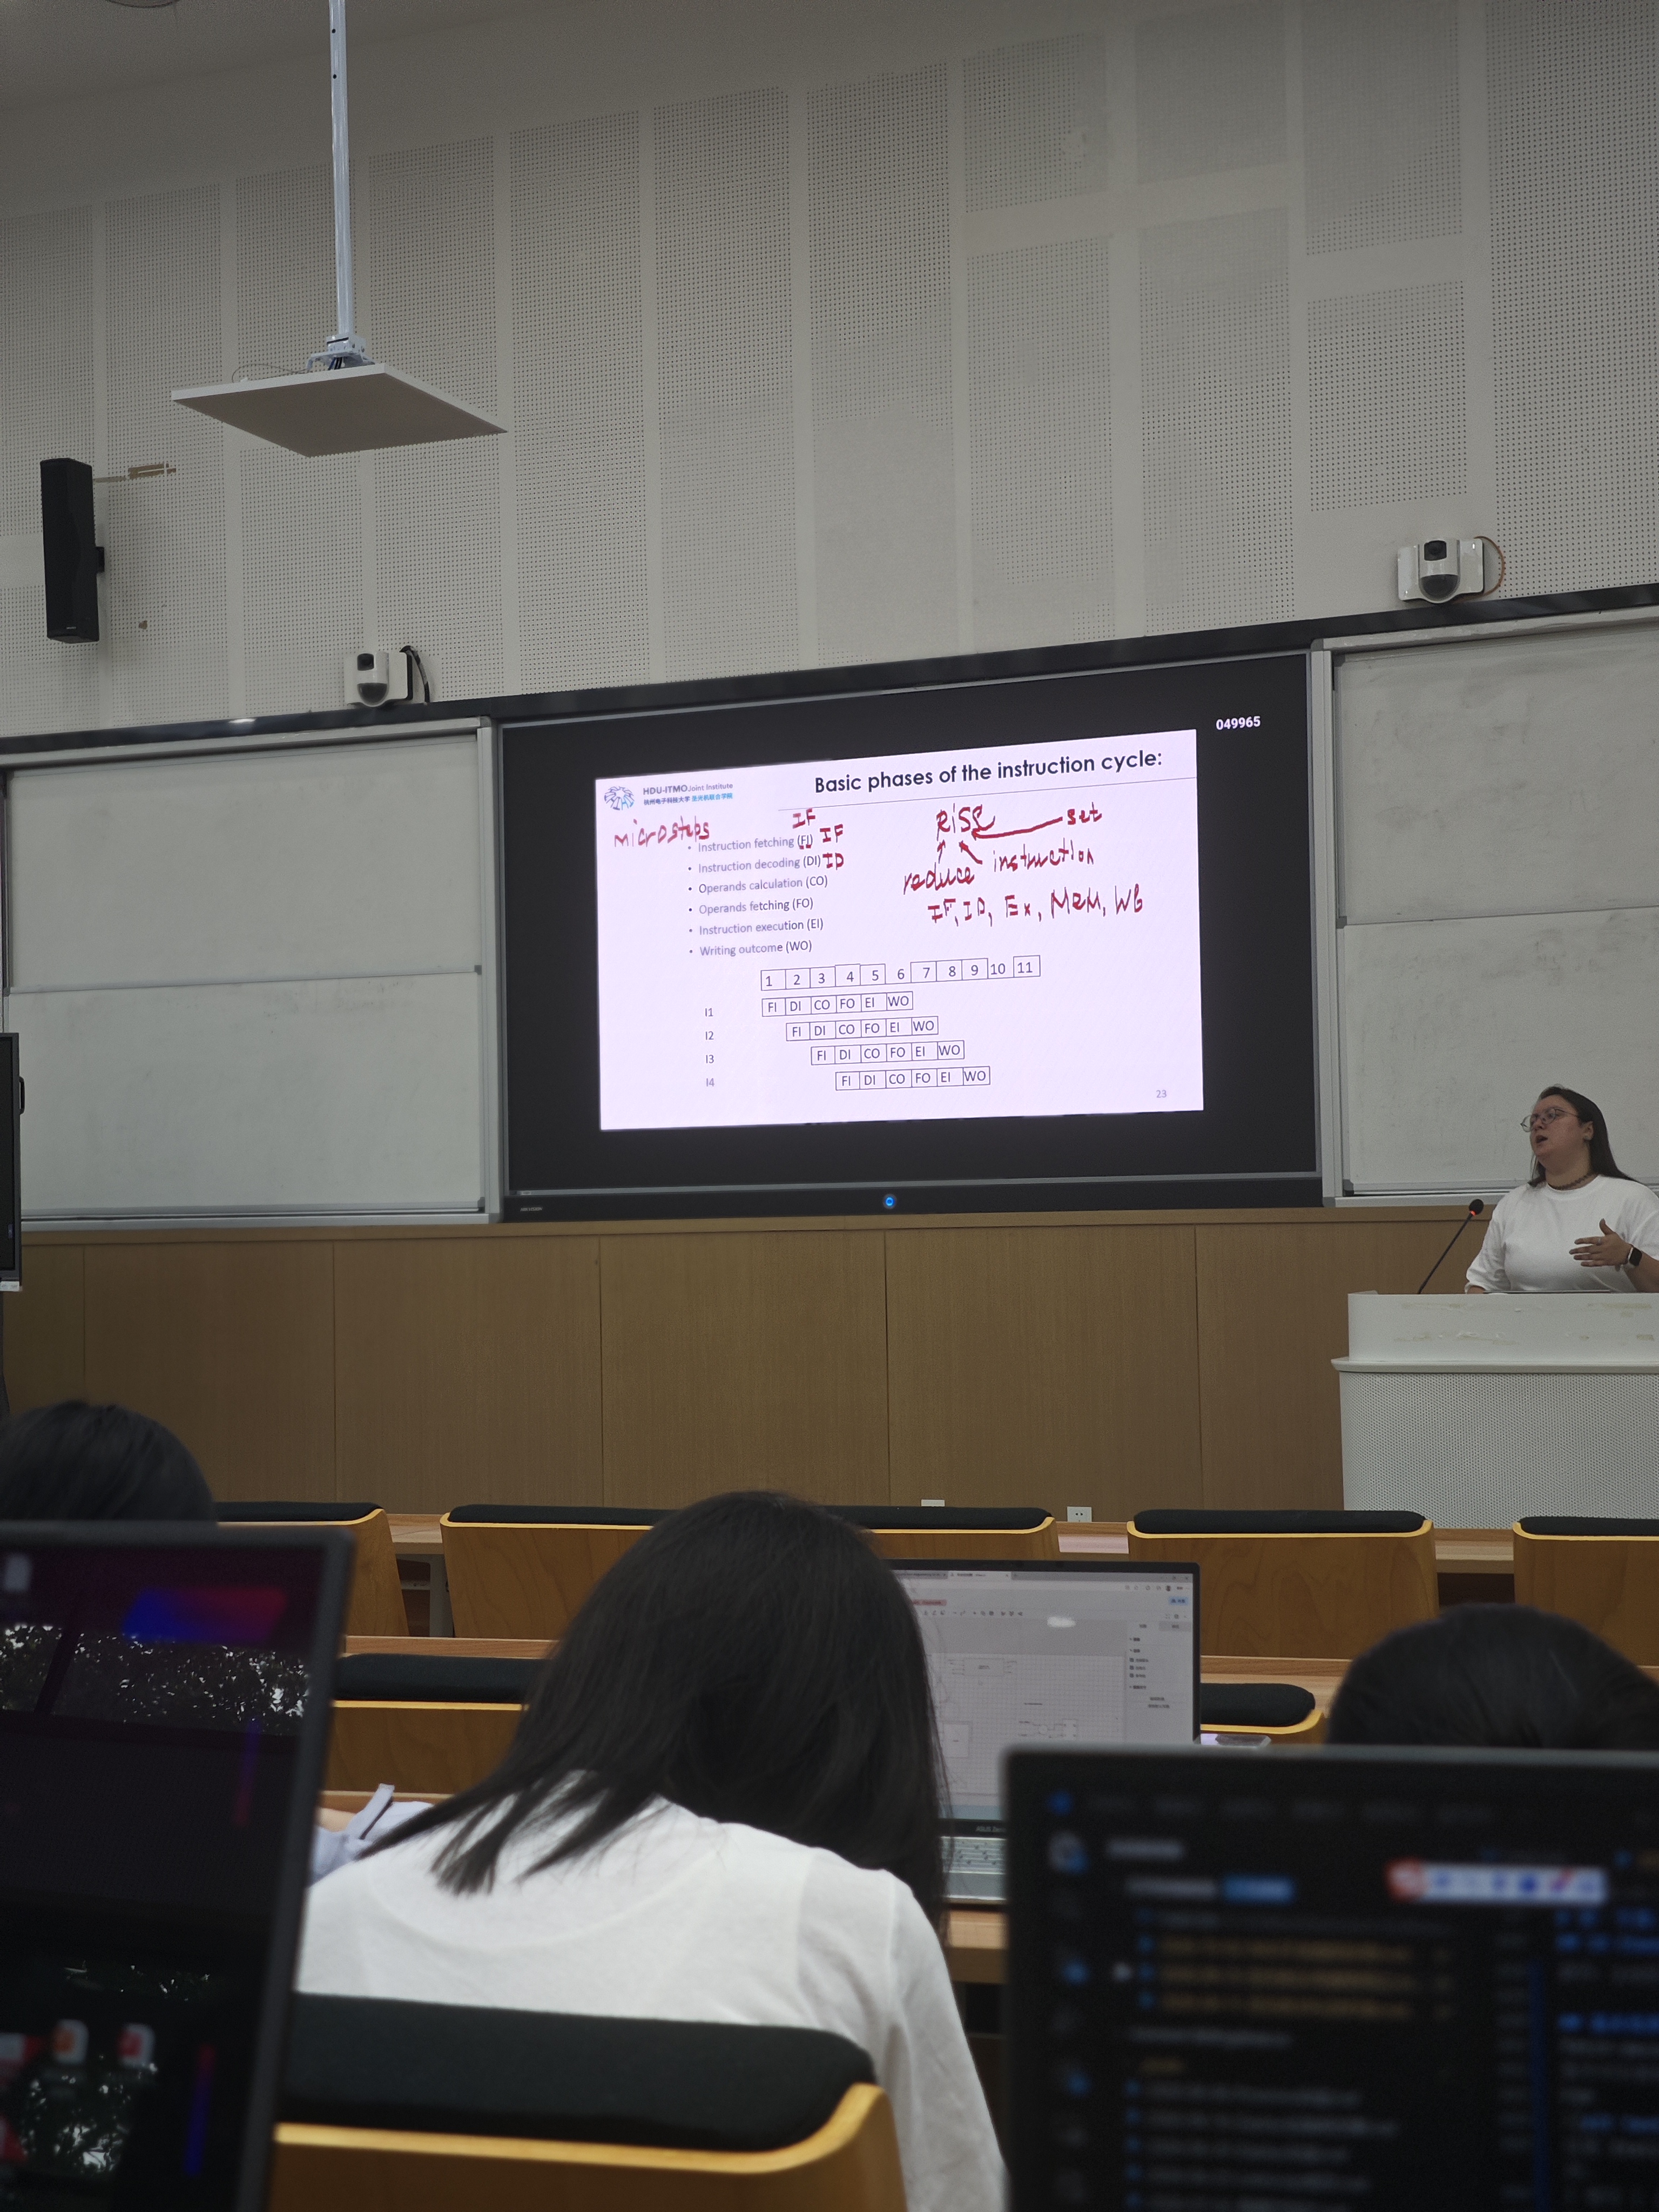 (这里懒得把图截出来了….所以如果图中被框进去的漂亮妹妹/姐姐感到冒犯我再改)
每一行是一条指令(I1、I2、I3);
每一列是一个时钟周期(顶部标的 1~11 就是时间轴,一格一拍);
每个格子表示“这条指令在这拍处于哪个阶段”;
每过一个周期,整行往右挪一格——因为流水线的规矩是:每拍结束,每条指令往前推进一个阶段,同时新指令从入口进来。(很像栈吧?)
这里的表述和常用的有一些不同,因此列个表格如下:
| 本页(Stallings) | MIPS 五级 | 干什么 |
| — | — | — |
| FI | IF | 取指 |
| DI | ID | 译码(顺便读寄存器) |
| CO | (并入 EX) | 算操作数地址 |
| FO | MEM | 取操作数(访存) |
| EI | EX | 执行 |
| WO | WB | 写回 |
后面是一些计算,我让AI总结了…
流水线性能计算(平均每条指令耗时)

已知:
  T_logic  = 不分段时一段逻辑的总时间(例:750 ps)
  d        = 每级流水线寄存器的锁存/建立开销(例:90 ps)
  N        = 流水线级数
  CPI      = 实际平均每指令周期数(含冒险 stall,例:1.25)

第 1 步:求流水线后的时钟周期
  T_clock = T_logic / N + d
  例:750/5 + 90 = 240 ps

第 2 步:求平均每条指令耗时
  T_avg = CPI × T_clock
  例:1.25 × 240 = 300 ps

第 3 步:求真实加速比
  S = T_logic / T_avg
  例:750 / 300 = 2.5×

注意:
  - d 每拍只加一次:一条指令一拍只跨一道锁存器,
    各级锁存器并联同时动作,开销不叠加
  - 单条指令延迟 = N × T_clock = T_logic + N·d(这是另一本账,不是性能指标)
  - N→∞ 时 T_clock → d,加速比上限 = T_logic / d,收益递减
当然这是理想条件下的,很多情况下,接下来的指令依赖于上一条指令的情况,比如ifelse,jump。因此会出现多个孤立的流水线块组合形成实际的指令周期的情况。在图中的例子里,如果你jumo到了8-15这个位置,之前的哪些复用流水线就浪费了。或者本来就不应该被执行。 因此,Pipline或者portion of Pipline必须stall。 stall(冻结):各级原地保持自己的指令不动,等依赖解决(典型:数据冒险)。指令没白取,只是晚走。 flush(冲刷):把某些级里的指令直接扔掉(典型:跳转猜错)。指令白取了。
types of harzards(冲突): resource data control | 冒险 | 成因 | 对策 | | — | — | — | | 结构/资源 | 两级同一拍抢同一硬件(FI 和 FO 都要访存) | 哈佛结构(指令/数据分开存储)、复制硬件 | | 数据 | 后条要用前条还没写回的结果 | 转发/旁路(forwarding)减小惩罚,不够再 stall | | 控制 | 分支结果出来前不知道下一条取哪 | 分支预测(猜错再 flush)、延迟分支 | 这就是前面“资源冒险”的由来。
bubble/IDLE —— 就是时序图里的空格子:一个气泡 = 某一级在这一拍空转 = 浪费一拍。气泡越多,实际 CPI 越偏离理想值 1。之前那个 CPI=1.25 就是这里来的(0.25 就是平均每条指令摊到的气泡)。
后续的内容就是对三种harzard的解释,例如寄存器冲突类型(结构/资源),控制冲突(branch hazard)
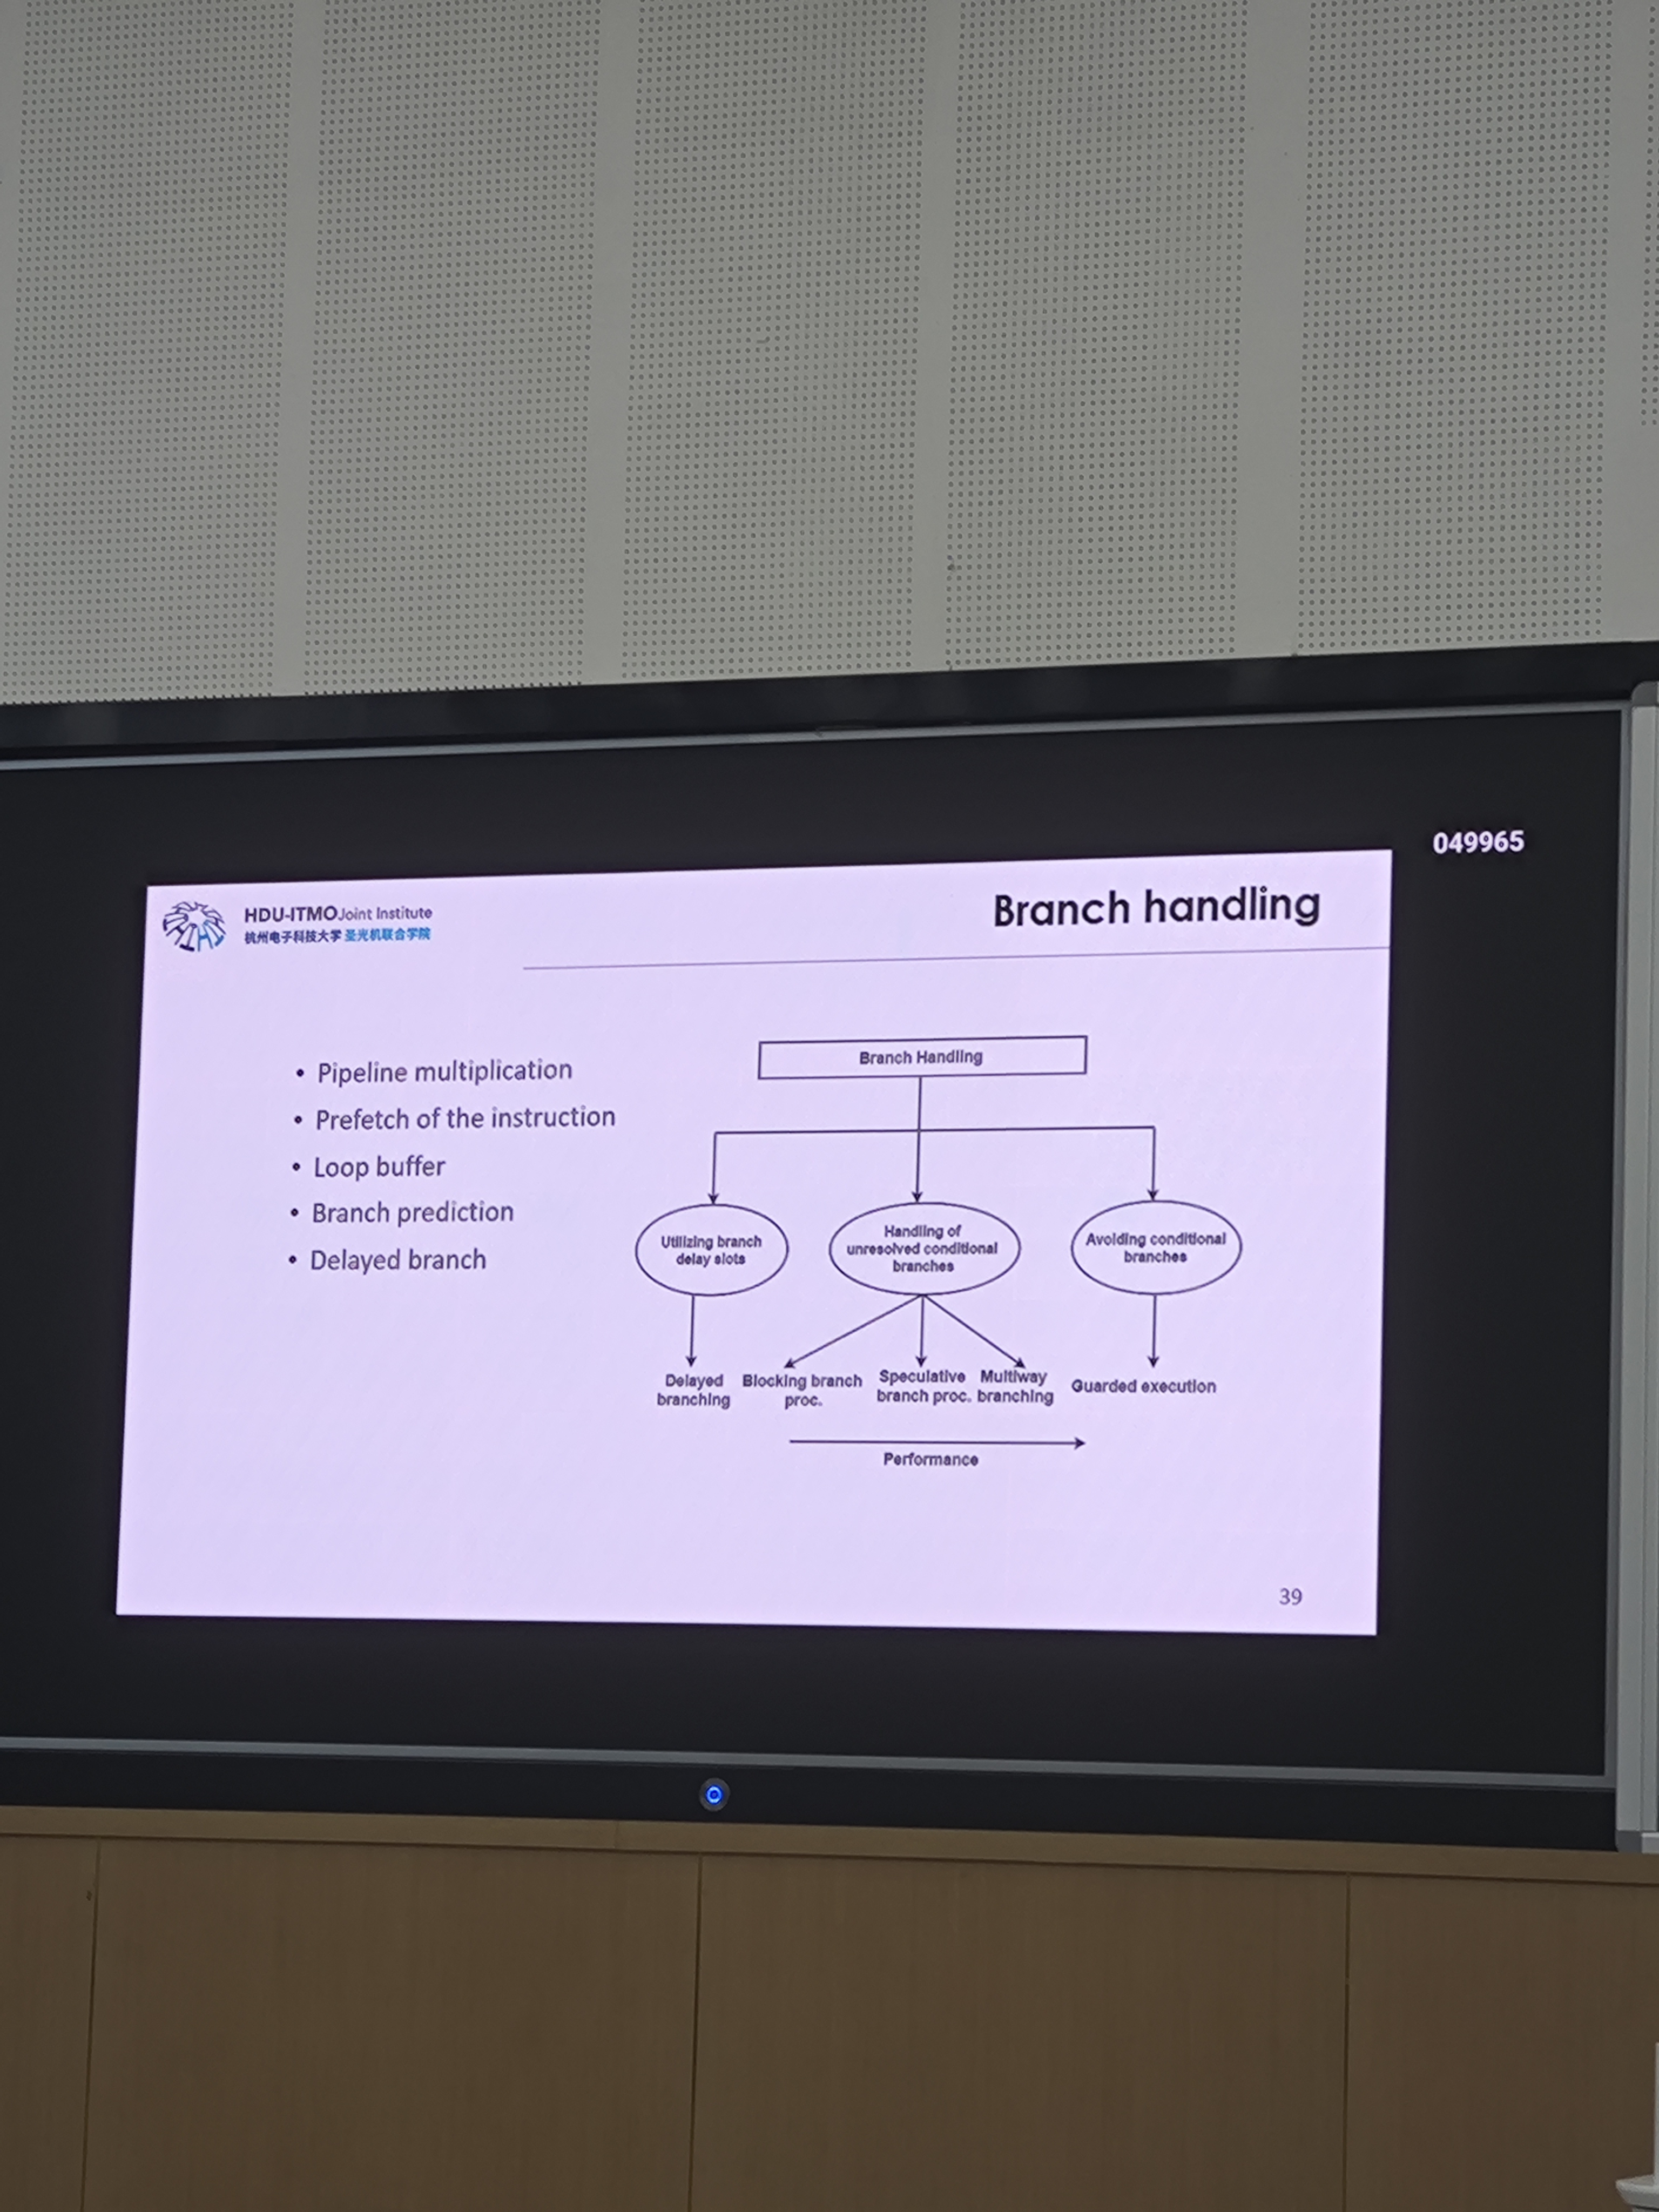
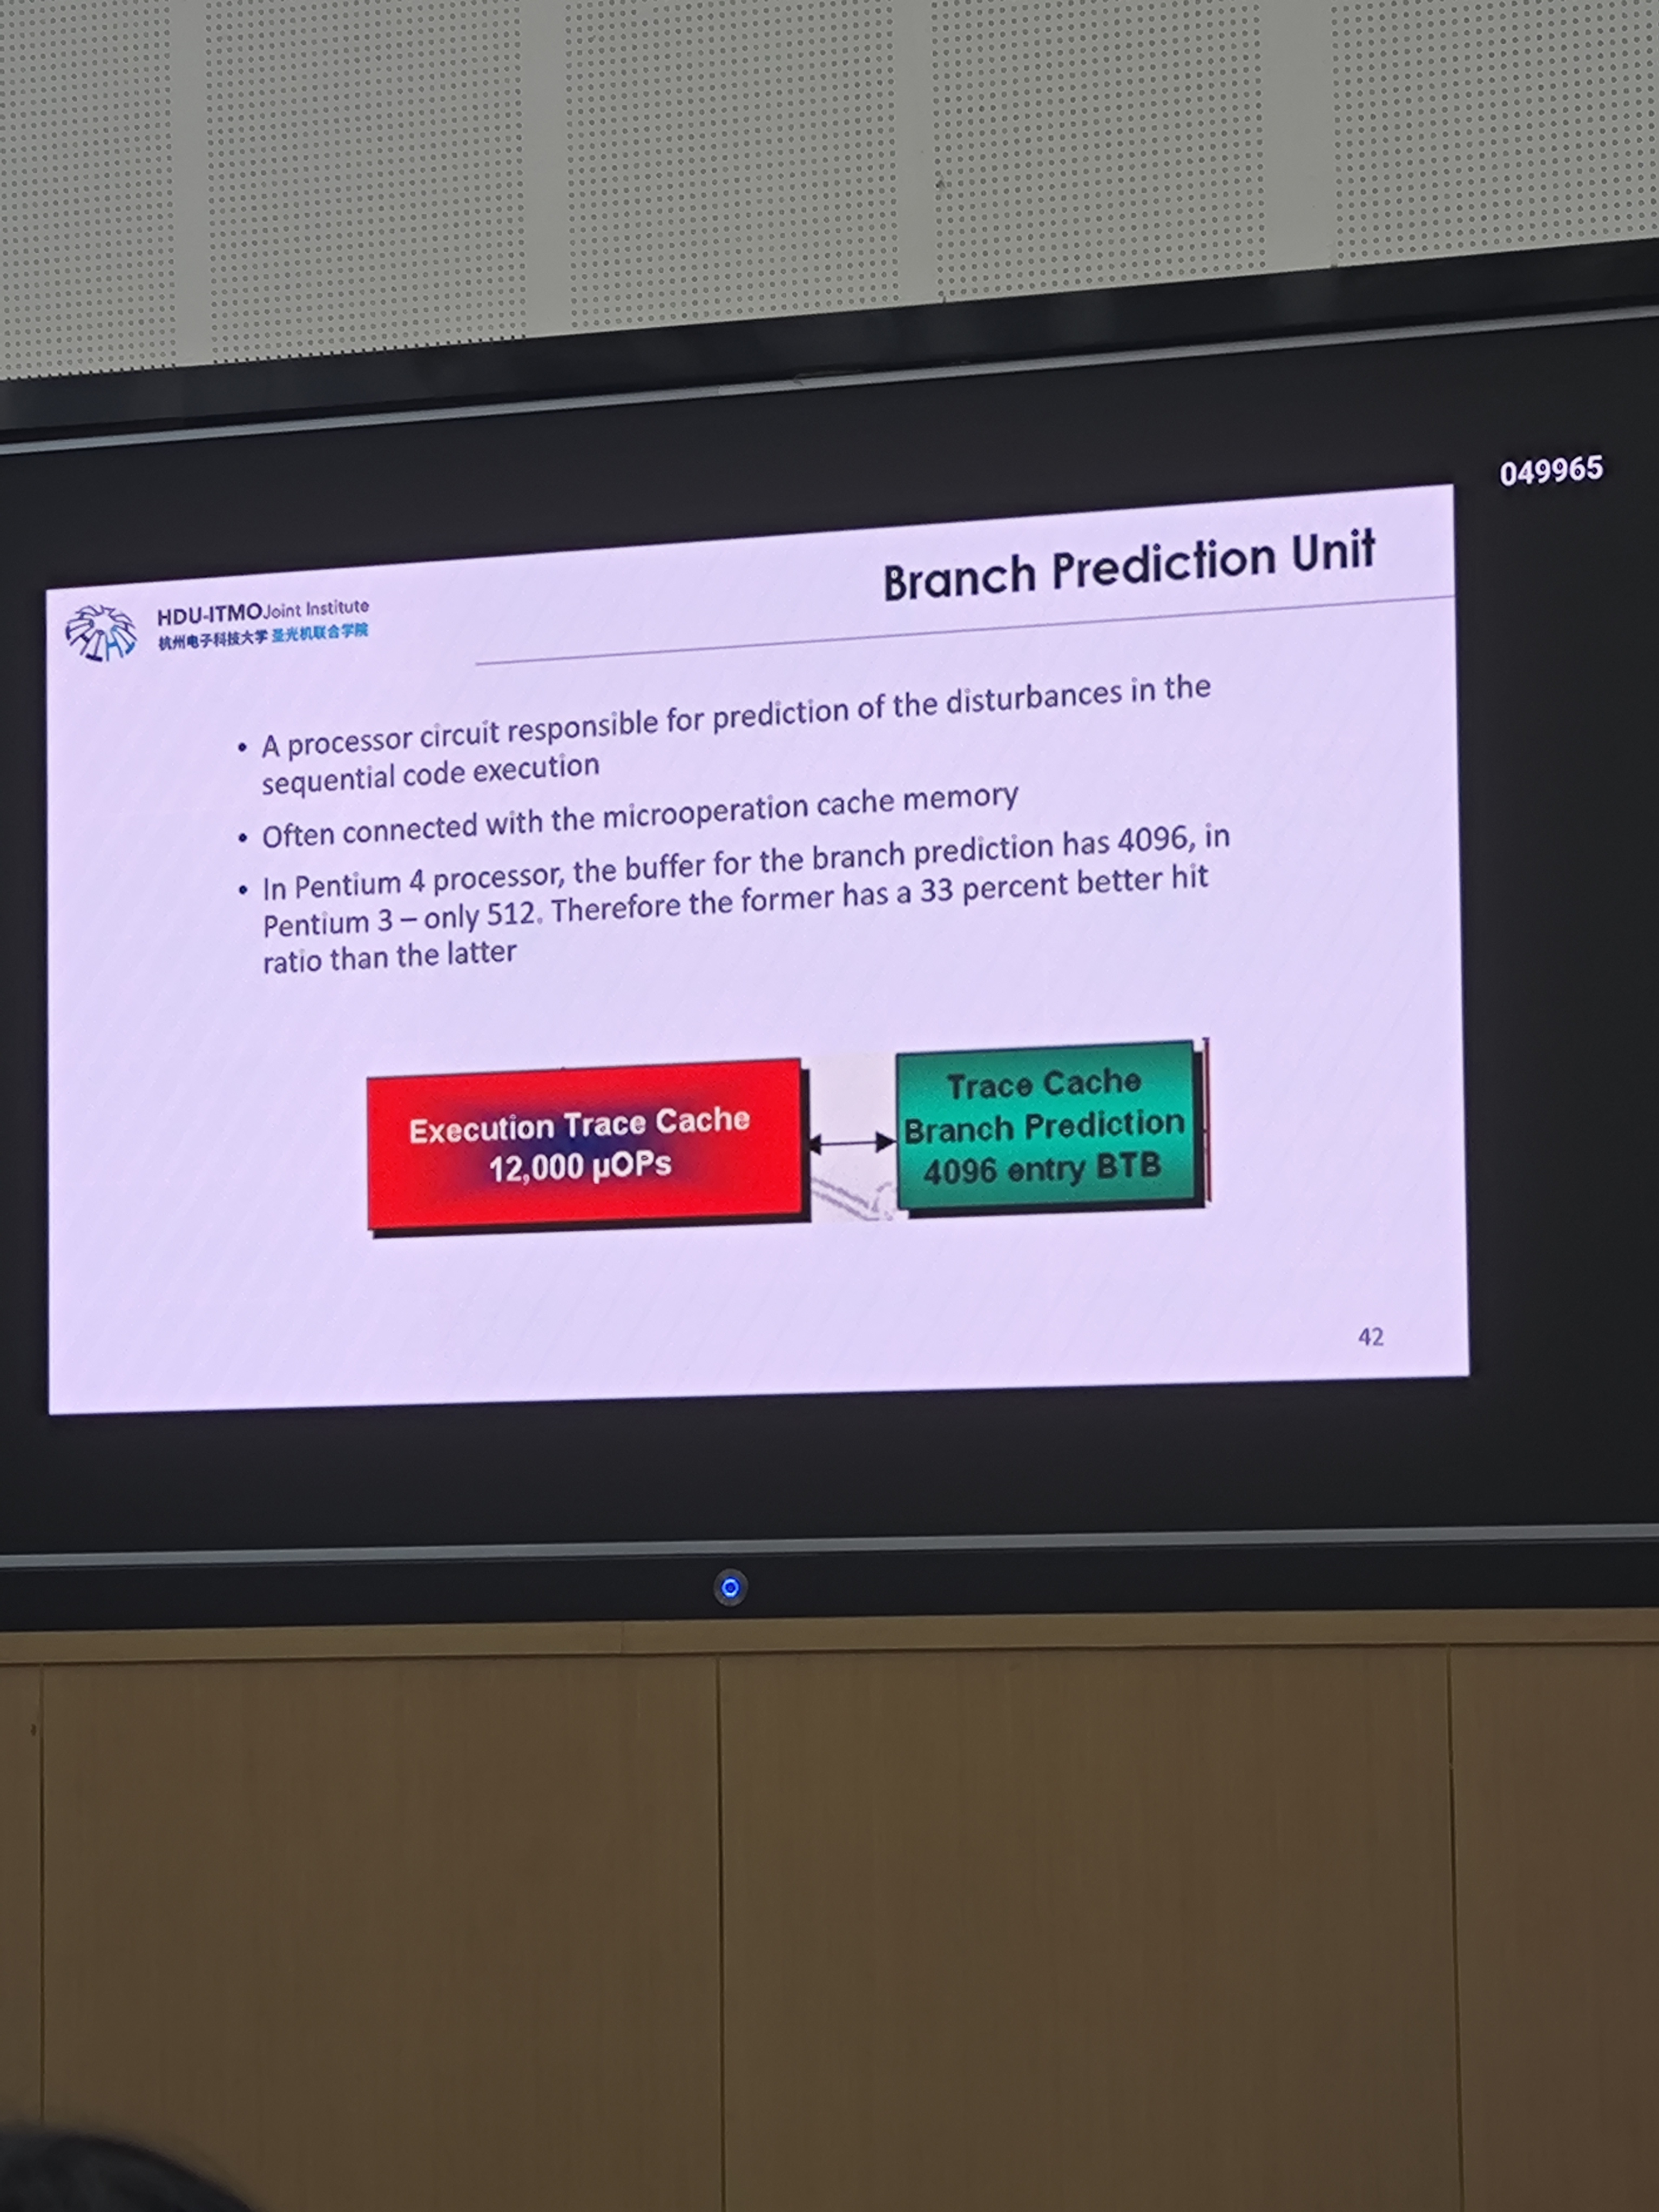
这就引入了一些解决办法: 分支预测:
又叫Speculative branch processing(投机执行):猜一条路继续跑,结果出来猜对了白赚,猜错了 flush回滚不亏。这就是现代 CPU 的标准答案——它 = 左边列的 branch prediction(负责猜)+ 硬件回滚机制(负责兜底)。一般来说猜得算准(现代预测器 95%+)。分成静态预测和动态预测,前者是SPARC,MIPS,后者是:[待补充喵] 之后还有什么公共分支预测,单独分支预测之类云云,不展开了,即使可能是考点。
Delayed branching(延迟分支):
往bubble里面塞一些莫名其妙的指令,就是不管有没有分支都要执行的。
Guarded execution(守卫/谓词执行):
釜底抽薪:直接消灭分支。if-else 两个分支的指令都执行,但每条带一个“守卫位”(谓词),条件成立的那份结果生效,另一份自动丢弃。分支比较多的时候好用。